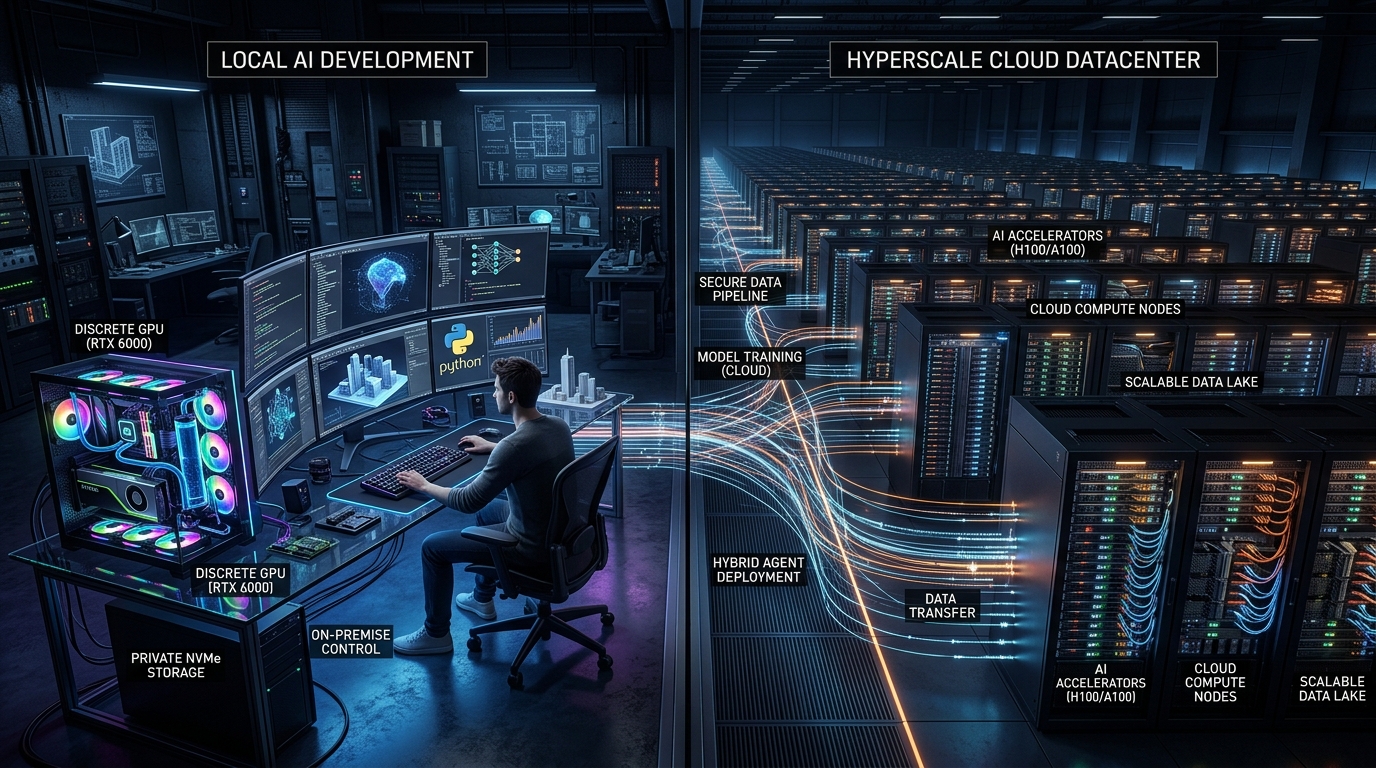
AIエージェントを使い始めると、いずれ次の疑問が出てきます。
このAgentは、どこで動かすべきなのか。
OpenAIやGoogleなどのクラウドサービス上で動かす。
自分のPCや社内サーバーで動かす。
あるいは、
モデルの推論はクラウドへ任せながら、ファイル操作やコード実行だけをローカルで行う。
現在のAIエージェントは、
CloudかLocalかという二択ではありません。
むしろ、
- Model
- Tool
- Data
- Execution Environment
をどこへ置くかを、それぞれ考える必要があります。
最初に結論から整理します。
⚡ 30秒で分かる結論
AIエージェントの配置には、大きく3つの考え方があります。
Cloud

Model        → Cloud
Agent        → Cloud
Tool         → Cloud
Execution    → Cloud
Local

Model        → Local
Agent        → Local
Tool         → Local
Execution    → Local
そして、
Hybrid

Model        → Cloud
Agent        → Cloud / Local
Tool         → Local
Execution    → Local
です。
CORE SPECでは、次のように考えます。
まずCloudを基本形として考え、データ・実行環境・コスト・計算資源などにLocalへ置く明確な理由がある場合にLocal / Hybridを検討する。
これが最もシンプルです。
Local Agentは高度だから選ぶものではありません。
Cloud Agentも初心者向けだから選ぶものではありません。
重要なのは、
Agentを、仕事とデータに近い場所へどう配置するか
です。
1. 「Agentをどこで動かす」とは何を意味する?
最初に整理したいのは、
AgentがLocalかCloudか
という表現には、複数の意味が含まれていることです。
AIエージェントは、一つの塊ではありません。
大まかに分けると、
Model
↓
Agent Harness
↓
Tool
↓
Execution Environment
↓
Data
というレイヤーがあります。
したがって、
「Local Agent」
と言っても、
すべてがLocalとは限りません。
2. ModelだけCloudという構成もある
たとえば、
GPT / Claude / Gemini
      ↓
Cloud API
      ↓
Agent
      ↓
Local File / Shell
という構成です。
モデルの推論はクラウドで行い、
実際のファイル操作やコマンド実行は自分のPCで行います。
OpenAIのShell Toolも、OpenAI管理のHosted Containerだけでなく、開発者自身が用意したLocal RuntimeでShell Commandを実行できる構成を公式にサポートしています。OpenAIは、Local Runtimeを使うことで実行環境・Filesystem Access・内部Toolを開発者側で制御できると説明しています。
つまり、
Cloud Model
+
Local Execution
は特殊な例ではありません。
Agentでは十分あり得る構成です。
3. Local Agent=Local LLMではない
ここは重要です。
Local Agentという言葉から、
Local Agent
=
Local LLM
と考えがちです。
しかし必ずしもそうではありません。
たとえば、
Cloud Model
↓
Local Agent Runtime
↓
Local File
↓
Local Shell
もLocal寄りのAgent構成です。
逆に、
Local LLMを使っていても、
ToolやDatabaseがCloudにあるケースもあります。
したがって、
「Modelがどこにあるか」と「Agentがどこで仕事をするか」は分けて考えます。
4. Cloud Agentとは?
この記事では、
ModelやAgent Runtime、主要なTool実行環境をCloudサービス側へ置く構成
をCloud Agentと呼びます。
たとえば、
User
↓
Cloud Agent
├ Cloud Model
├ Web Search
├ SaaS
└ Cloud Sandbox
という構成です。
Google CloudのAgent Platformには、AI生成コードを隔離されたCode Execution Sandboxで実行する仕組みがあります。同じSandboxを再利用する後続のExecute Code呼び出しでは、変数やファイルなどの実行状態を維持できます。
Cloud側に、
- Model
- Runtime
- Sandbox
- Tool
をまとめて持つことができます。
5. Cloudの最大の利点は「自分で持たなくてよい」こと
Cloud Agentの大きなメリットは、
AI実行基盤を自分で構築・維持しなくてよい
ことです。
Localなら、
- Model
- Runtime
- GPU
- Driver
- Storage
- Update
- Security
などを自分で管理する必要があります。
Cloudでは、その多くをサービス側へ任せられます。
したがって、
Agent設計そのものへ集中しやすい
という利点があります。
6. 最新の高性能Modelを利用しやすい
Cloudを使うもう一つの理由は、
高性能なModelを自分で動かす必要がないことです。
大規模なModelを使うために、
自分で巨大なGPU環境を用意する必要はありません。
APIやサービスとして利用できます。
つまりCloudでは、
Model能力
≠
自分のGPU能力
です。
自分のPC性能と、利用できるAIの能力を切り離せます。
7. ではLocal Agentを選ぶ理由は?
Localの特徴は、
Agentを自分のデータ・ファイル・LAN・計算資源に近い場所へ配置・制御しやすいこと
です。
ここで重要なのは、
Localなら何でも自由にアクセスできる
という意味ではありません。
Agentのアクセス範囲は、
- Tool
- Harness
- Permission
- Sandbox
によって決まります。
⑥ Sandboxと安全設計で見たように、Local環境でもSandboxを使うべきケースがあります。
OpenAIもLocal Shellを含む任意のShell Command実行について、Sandbox・Allowlist・Denylistなどを利用することを推奨しています。
8. Localのメリット① データを近くに置ける
たとえば、
- 社内Document
- 制作素材
- Source Code
- NAS
- Local Database
- 大量の映像ファイル
などを扱う場合です。
Cloudへ毎回Uploadするより、
Agent
↓
Local Data
の方が自然な場合があります。
これは、
Localだから必ず安全
という話ではありません。
重要なのは、
Data Locationを自分で管理しやすい
ことです。
9. Localのメリット② 自分の計算資源を使える
Local LLMを使う場合、
ModelのInferenceも自分のPCで行えます。
現在はOllamaのようなLocal LLM RuntimeでもTool Callingをサポートしており、Local Modelを外部FunctionやAPIへ接続できます。
llama.cppのServerも、
- OpenAI互換API
- Anthropic Messages API互換
- Function Calling / Tool Use
をサポートしています。
つまりLocal LLMは、
ChatGPTのように会話するだけ
ではなく、
AgentのModel Layerとして使う
ことも可能です。
10. Local LLMを使うとGPUがAgent設計へ入ってくる
Cloud Agentでは、
GPUは基本的にサービス側の問題です。
しかしLocal LLMを使うと、
Model
↓
VRAM
↓
GPU
↓
Inference Speed
という関係が生まれます。
つまり、
PCスペックがAgentの実行環境の一部になる
ということです。
ここがCORE SPECにとって重要です。
ただしこの記事では、
- 7B
- 14B
- 32B
- 70B
- Quantization
- GGUF
などの詳細には入りません。
必要VRAMやModel Sizeの判断は、
Local LLM関連記事・VRAM診断
へ委ねます。
11. Localのメリット③ API従量課金を減らせる場合がある
Cloud Modelでは一般に、
API利用量やSubscriptionなどの費用が発生します。
Agentでは、
Model Call
↓
Tool
↓
Model Call
↓
Tool
↓
Model Call
と、一つのTaskで複数回Modelを呼ぶ場合があります。
そのため利用量が増えると、
Cloud Costが判断要素になります。
一方Local LLMなら、
Model CallごとのAPI料金ではなく、
PC購入
+
GPU
+
電力
+
管理
という別のCost構造になります。
どちらが安いかは、
利用頻度と既存設備
によって変わります。
12. Localなら無料、ではない
ここも注意が必要です。
Local Modelを使えばAPI料金を抑えられる場合があります。
しかし、
- GPU購入費
- 電力
- Storage
- Maintenance
- Setup
- Upgrade
は必要です。
したがって、
Cloud
=
お金がかかる

Local
=
無料
ではありません。
より正確には、
Cloudは利用量ベースのCostを持ちやすく、Localは計算資源を自分で持つCostを持ちやすい
という違いです。
13. Localのデメリット① Model能力が計算資源に制約される
Local LLMでは、
自分のGPUやMemoryに載るModelを選ぶ必要があります。
当然ながら、
すべてのCloud ModelをそのままLocalで動かせるわけではありません。
したがって、
知能を優先するならCloud
という判断になるケースがあります。
特に、
- 難しい推論
- 長いContext
- 複雑なTool選択
- 長時間の自律処理
では、Model能力がAgent全体の品質へ影響します。
14. Localのデメリット② 環境管理が自分の仕事になる
Cloudではサービス側へ任せていた、
- Runtime
- Update
- Driver
- Security
- Resource Limit
- Monitoring
などをLocalでは自分で管理する必要があります。
つまりLocal Agentは、
自由度が増える
一方で、
管理責任も増える
構成です。
15. Localのデメリット③ 実環境へ近いほど権限設計が重要になる
Agentを自分のPCへ置く場合、
- Source Code
- Documents
- NAS
- Local Network
などへ近づきます。
これはLocalのメリットです。
しかし同時に、
誤操作の影響範囲も考える必要があります。
そのため、
Local Agent
↓
Local Sandbox
↓
限定されたDirectory
↓
限定されたNetwork
という構成が重要になる場合があります。
つまり、
「近いから便利」と「近いから安全」は別です。
16. Hybridという第三の選択肢
実際には、
CloudとLocalの中間がかなり重要です。
たとえば、
Cloud GPT / Claude / Gemini
↓
Agent
↓
Local Shell
↓
Local Repository
という構成です。
この場合、
高性能なModelはCloudで利用しながら、
実際の仕事はLocal環境で行います。
OpenAIのShell ToolがHosted EnvironmentとLocal Runtimeの両方を提供しているのは、このような分離が可能である具体例です。
17. Hybridのメリット
Hybridでは、
CloudとLocalの特徴を組み合わせられます。
Model
Cloudの高性能Model
Data / Files
Local
Execution
Local Sandbox
External Tool
Cloud SaaS / MCP
という設計ができます。
つまり、
知能
↓
Cloud

仕事場
↓
Local
という構成です。
Coding Agentでは特に自然な考え方です。
18. Hybridだから安全というわけではない
ただし、
Cloud Modelへ何を送るかは考える必要があります。
たとえばLocal FileをToolで読んだ後、
その内容をContextとしてCloud Modelへ渡せば、
データはCloud側へ送られます。
したがって、
DataはLocal
=
Dataが外へ出ない
とは限りません。
見るべきなのは、
情報がAgent Stackのどこを通るのか
です。
19. Data LocationとModel Locationを分けて考える
Agent配置を考えるときは、
次の2つを分けると分かりやすくなります。
Model Location
推論をどこで行うか。
Data Location
処理対象をどこに置くか。
たとえば、
Model   Cloud
Data    Local
もあり、
Model   Local
Data    Cloud DB
もあります。
つまり、
Local / Cloudは一つのSwitchではありません。
20. Tool Locationも別に考える
さらに、
Toolも別です。
Agent
├ Local Shell
├ Local Files
├ Cloud Search
├ SaaS API
└ Remote MCP
という混在が可能です。
Agent設計では、
Modelをどこに置くか
だけでなく、
仕事に必要なToolをどこへ置くか
も考えます。
21. Cloudが向いているケース
まずCloudを検討しやすいのは、
最新・高性能Modelを優先したい
GPUを自分で管理したくない
SaaSやWebサービス中心で仕事をする
短期間でAgentを構築したい
利用量がまだ少ない
Infrastructure管理を減らしたい
場合です。
特に、
まずAgentを作ってみたい
段階ならCloudの方がシンプルです。
22. Localを検討するケース
Localを検討する意味が出てくるのは、
大量のLocal Dataを扱う
社内LANやNASとの近接性が重要
Data Governanceを自分で管理したい
Local LLMを継続的に利用したい
GPUをすでに持っている
Infrastructureを自分で管理できる
といった場合です。
重要なのは、
Localでなければならない理由があるか
です。
23. Hybridを検討するケース
Hybridは、
Model性能はCloudを使いたい
FileやCodeはLocalに置きたい
Local Toolを使いたい
Cloud SaaSも同時に使いたい
というケースに向きます。
たとえばCoding Agentなら、
Cloud Model
↓
Local Repository
↓
Local Test
↓
GitHub
という形です。
現在のAgent環境では、かなり自然な構成です。
24. Cloud vs Localを簡単に比較する
大まかに整理すると、
| 判断軸 | Cloud | Local |
|---|---|---|
| 導入 | 比較的容易 | 環境構築が必要 |
| Model性能 | 高性能Modelを利用しやすい | 自分の計算資源に依存 |
| GPU | 基本的にサービス側 | 自分で用意 |
| Data | Cloudへ渡す設計になりやすい | 手元で管理しやすい |
| Local File | Tool経由 | 近接配置しやすい |
| SaaS連携 | 得意 | API / MCP等で連携 |
| 管理 | サービス側へ委譲しやすい | 自分で管理 |
| API費用 | 利用量に応じて発生 | 抑えられる場合あり |
| 初期投資 | 比較的小さい | GPU等が必要になる場合あり |
| Customization | サービス仕様内 | 高い |
| Offline | 基本的に難しい | 構成次第で可能 |
ただし、これは「Cloudの方が優れている」「Localの方が優れている」という優劣を示す表ではありません。
何を優先するかによって、適した構成は変わります。
25. 判断を難しくしない
Agentの実行環境を考え始めると、
- Ollama
- llama.cpp
- vLLM
- Docker
- Kubernetes
- MCP
- GPU
- Quantization
など、多くの技術が出てきます。
しかし最初から全部理解する必要はありません。
判断はもっとシンプルにできます。
26. CORE SPECの判断フロー
まず、
Cloudで問題なく動く?
↓
YES
↓
Cloudを基本形にする
これで十分なら終わりです。
Cloudでは困る理由が出たら、
Cloudで困る理由は?

├ Dataを外へ出しにくい
├ Local File / LANへ近づけたい
├ API Costが大きい
├ Local LLMを使いたい
└ 自前計算資源を活用したい
ここで初めて、
Local / Hybrid
を検討します。
27. Localに全部移す必要もない
たとえば、
API Costだけが問題なら、
一部TaskだけLocal Modelへ移すこともできます。
難しい判断
→ Cloud Model

単純な分類
→ Local Model
という構成です。
あるいは、
Planning
→ Cloud

Execution
→ Local
でもよい。
つまりAgentでは、
全部Cloudか全部Localか
で考える必要はありません。
28. Local LLMは第四の「ベンダー」ではない
今回のAIエージェント設計シリーズでは、
- OpenAI
- Anthropic
というCloud系の実装を見てきました。
そこへLocal LLMを加える場合、
「第四の会社」として扱うのは少し違います。
Local / Open Sourceは、
Modelや実行環境をどこへ置くかという別の設計軸
です。
OpenAI
Anthropic
Google

      +

Local / Open Source
という3+1で考えると整理しやすくなります。
29. Local AgentとPC選びがつながる
ここまで来ると、
AI学習とPC選びがつながります。
Cloud Agentでは、
どのAgent Platformを選ぶか
が中心でした。
Local Agentでは、
どのModelを動かす?
↓
必要VRAMは?
↓
どのGPU?
↓
どのPC?
という判断が生まれます。
つまり、
計算資源そのものがAgent Architectureの一部になる
ということです。
30. ただし高性能GPUを買えば良いわけではない
ここでもCORE SPECの考え方は同じです。
最高性能のGPUを買うことが目的ではありません。
まず、
Local Agentが本当に必要なのか
を判断する。
必要なら、
どの程度のModelをLocalで動かしたいのか
を判断する。
その後に、
必要なVRAM・GPU
を考えます。
順序は、
用途
↓
Agent配置
↓
Model
↓
必要VRAM
↓
GPU
です。
GPUから決めるのではありません。
31. ローカルで動かすなら次に見るべきもの
Local Agentを選ぶ場合、
次に必要になるのは、
- Local LLM
- Model Size
- VRAM
- GPU
の判断です。
Ollamaやllama.cppのようなRuntimeでLocal ModelをTool Callingへ接続できる現在、Local LLMはAgentのModel Layerとして現実的な選択肢になっています。
ただし、
具体的な環境構築はこの記事の役割ではありません。
32. Agent配置は固定ではない
最初はCloudで始めても構いません。
利用が増えたら、
一部をLocalへ移す。
逆にLocalで始めて、
難しいTaskだけCloudへ送る。
という変更もできます。
つまり、
Cloud / Localは最初に永久決定するものではない
ということです。
Agent Architectureの一部として、
後から変えられます。
33. Agent時代のPCは「AIを動かす箱」だけではない
Local Agentまで考えると、
PCの意味も少し変わります。
従来は、
PC
↓
Softwareを動かす
でした。
AI時代には、
PC
↓
Model
+
Agent
+
Tool
+
Data
という環境にもなります。
つまりPCは、
AIが仕事をする場所
にもなり得ます。
これは、Local LLMとAgentがつながることで見えてくる変化です。
34. CORE SPECの結論
AIエージェントを、
いきなりLocalで構築する必要はありません。
まずCloudで、
Agentそのものが仕事に有効か
を確認する。
そこで、
- Data
- Privacy
- Local File
- Cost
- GPU
- Governance
に理由が生まれたら、
Local / Hybridを検討する。
これがシンプルです。
Cloud
↓
まずAgentの価値を確認

↓

必要性が出たら

↓

Hybrid
or
Local
Local LLMは、
Agentを難しくするための技術ではありません。
Agentを自分の計算資源とデータへ近づけるための選択肢
です。
まとめ
AIエージェントの実行環境は、
単純なCloud vs Localではありません。
考えるべきなのは、
Model
Agent
Tool
Execution
Data
を、
それぞれどこへ置くか
です。
Cloudは、
- 導入しやすい
- 高性能Modelを使いやすい
- Infrastructureを任せやすい
という強みがあります。
Localは、
- Dataに近い
- 自分の計算資源を使える
- Controlしやすい
という強みがあります。
そしてHybridでは、
Cloudの知能とLocalの実行環境
を組み合わせることができます。
最も重要なのは、
Localの方が高度なのではなく、Localにする理由があるか。
です。
❖ AIエージェント設計シリーズ(全8回)
- #01 OpenAI Agents APIとは?
- #02 AIエージェントとは?設計の基本
- #03 AIエージェントのToolとは?
- #04 Single vs Multi-Agentの違い
- #05 Agentの「状態」とMemory設計
- #06 AgentのSandboxと安全設計
- #07 AIエージェントのEvalとテスト設計
- #08 Local vs Cloud Agentの使い分け(現在地)