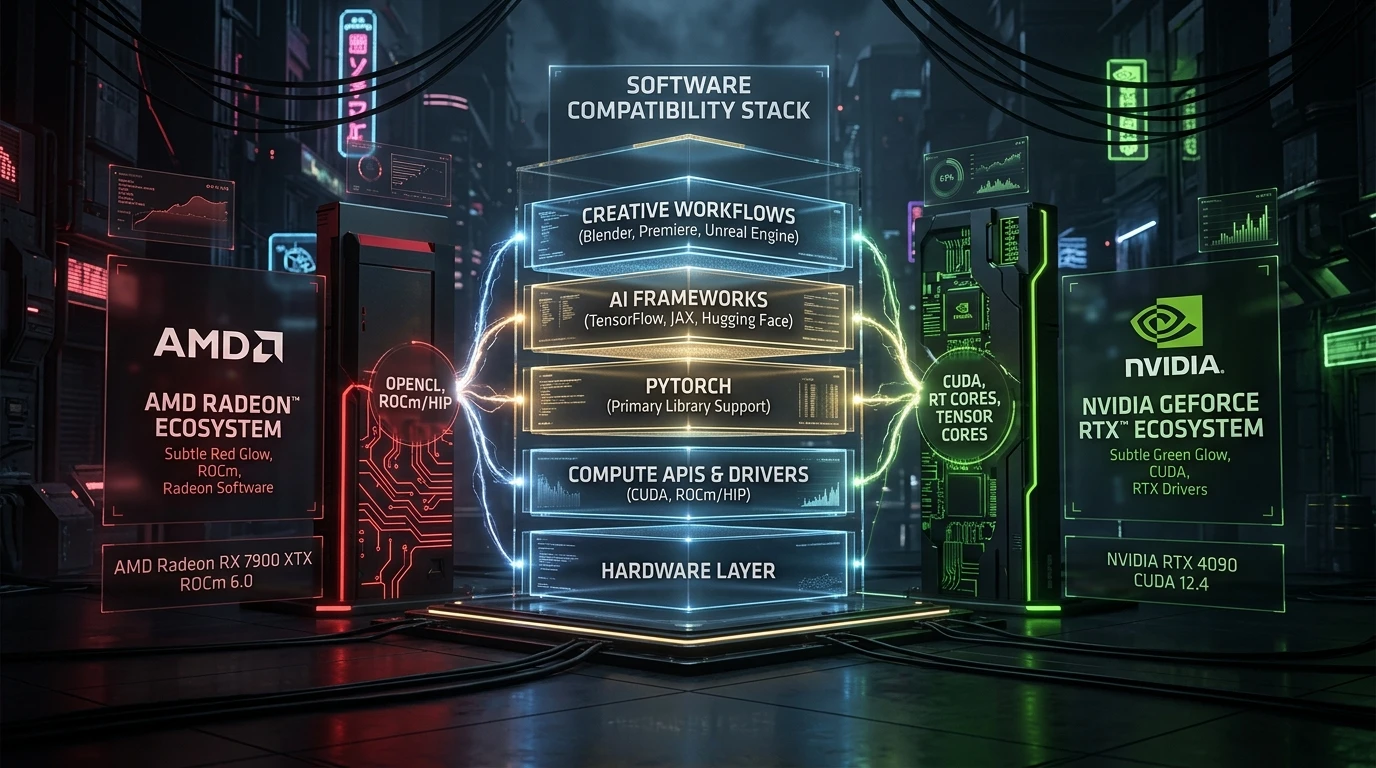
スペック表の数値比較にとどまらず、「計算資源をどう持ち、何に使い、どのような価値へ変換するか」を用途から考えるシリーズです。第11回は、計算資源の「互換性とソフトウェア制約」──GPU性能の数字だけでなく、CUDAとROCm、PyTorch、ComfyUI、TouchDesignerの制作フロー全体からGPUの本当の選び方を整理します。
計算資源シリーズ一覧を見る →GPUの価格とVRAM容量を見比べているとき、多くの人が一度は気になる疑問があります。
💡 「AMD Radeonは、生成AIやクリエイティブ制作に使えないのか?」
結論から言えば、「RadeonではAIが動かない」という時代は終わりました。
2026年現在、AMDの計算プラットフォームROCmの対応は大きく進み、PyTorch、Ollama、ComfyUIなど主要なAIツールでAMD GPUがサポートされる範囲は確実に広がっています。
しかし同時に、「それでも生成AI・クリエイティブ制作PCとしてGeForce RTXが強く推奨される理由」も依然として極めて明確です。
この記事では、単なるブランド比較ではなく、CUDAとROCmの現在地、用途別の対応状況、そしてTouchDesignerなどの映像制作まで含めた実践的な判断基準を整理します。
用途別:RadeonとGeForceの対応状況一覧
まず、制作でよく使われるソフトウェアごとの対応度を整理します。
| 用途・ソフトウェア | Radeon | GeForce RTX | 実用上のポイント |
|---|---|---|---|
| ローカルLLM(Ollama等) | ◯ 実用可 | ◎ 快適 | ROCmに加え、OllamaではVulkanによるGPUアクセラレーションも標準有効化され、AMD GPUでローカルLLMを動かせる範囲が拡大。 |
| 画像生成(ComfyUI) | △ 条件付き | ◎ 標準 | 公式サポートはあるが、Custom Nodeや最適化バックエンドに制限あり。 |
| 動画生成(Wan2.1 / Hunyuan) | △ 環境依存 | ◎ 標準 | AMD対応の高速化技術も増えているが、モデル配布時の推奨環境やCustom Node、事前ビルド済みパッケージは依然CUDA中心。 |
| TouchDesigner(映像・リアルタイム) | △ 一部制限 | ◎ 推奨 | 基本機能は動くが、Optical FlowやAI系TOPなどNVIDIA専用機能が存在。 |
| DaVinci Resolve / Premiere Pro | ◯ 実用可 | ◎ 快適 | AMD GPUでも編集・GPUアクセラレーションは利用可能。AI機能や外部プラグイン、特定処理ではGPUごとの最適化差あり。 |
| ゲーム(ラスタライズ) | ◎ コスパ高 | ◎ 標準 | 純粋な描画性能とVRAM容量のコスパではRadeonが非常に強力。 |
CUDAとROCmの本質的な違いとは?
なぜこのような差が生まれるのでしょうか。それはハードウェア自体の処理能力ではなく、ソフトウェアのエコシステム(開発環境)の歴史と成熟度にあります。
2006年からの圧倒的な標準規格
- 多くのAI研究論文やライブラリ・サンプル実装が、まずCUDA環境を想定して公開される
- Windows / Linuxを問わずドライバ・環境構築が極めて安定
- TensorRT、cuDNN、TensorRT-LLMなどNVIDIA向け最適化ツールが充実
- トラブル時にWeb上に解決策(情報)が無数にある
急速に進化するオープンな挑戦者
- Linux環境を中心にデータセンターやPyTorch公式で手厚くサポート
- Windows対応(ROCm for Windows)も進んでいるが対象GPUが限定的
- コミュニティ製Custom Nodeや最新最適化の移植にタイムラグが発生
- エラー時の情報が少なく、自力でのトラブルシュートが必要
つまり、「Radeonで動くかどうか」ではなく、「世界中で新しく発表される最新のAI技術やワークフローを、少ない追加対応でスムーズに試せるかどうか」が最大の境界線なのです。
TouchDesignerとRadeon:リアルタイム映像制作のリアル
クリエイティブコーディングやインタラクティブアートで業界標準のTouchDesignerにおいても、GPU選びは制作の自由度を左右します。
Derivative公式のシステム要件において、TouchDesignerはWindows環境でAMD Radeon(RDNAアーキテクチャ以降)を公式にサポートしています。基本的なノード処理、GLSLシェーダー、3DレンダリングなどはRadeonでも問題なく動作します。
しかし、制作現場で差が出るのは以下の「NVIDIA専用機能」です:
⚠️ TouchDesignerでNVIDIA GPU(RTX)が必要になる主な機能
- Optical Flow TOP: カメラ映像から物体の動きベクトルをリアルタイム推定(NVIDIA Optical Flow SDK依存 / Windows+RTX 3000番台以上)
- NVIDIA Background TOP: AIによる人物・被写体のリアルタイム背景分離
- NVIDIA Denoise TOP: AIによる映像ノイズ低減およびH.264等の圧縮アーティファクト除去
- NVIDIA Upscaler TOP: リアルタイム映像の超解像・アップスケーリング処理
- ハードウェア処理: NVIDIA GPUによるH.264/H.265のハードウェアエンコード/デコード
ライブ演出や映像インスタレーションでAI機能や低遅延リアルタイム処理を組み込む場合、現場でRTXが選ばれ続けているのはこのためです。
結論:あなたはどう選ぶべきか?
計算資源としてのGPU選びは、「自分の制作フローにどの程度の不確実性を許容できるか」で決まります。
ゲーム中心 + 定番ローカルLLM
- 主な用途はPCゲームで、価格対VRAM容量のコスパを最優先したい
- ローカルLLMはOllamaで7B〜14Bの推論ができれば満足
- Linux環境やDockerの扱いに慣れており、設定を自力で解決できる
生成AI・動画・リアルタイム映像制作
- ComfyUI、Wan2.1、HunyuanVideoなどの画像・動画生成をフル活用したい
- TouchDesignerでAI系TOPやOptical Flowを使いたい
- RAG開発やAIエージェントのローカル実行まで挑戦したい
- 環境構築や互換性調査の時間を減らし、制作に集中したい
GPUとは単なる演算性能の数字だけではなく、自分の制作工程に残される選択肢の数でもあります。
※対応状況は2026年8月25日時点の情報です。導入前に各公式ドキュメントの最新版をご確認ください。
生成AI・クリエイティブ向けPCの選び方を見る
RTX 5070・5080・5090からRTX PRO 6000まで、用途とVRAM容量に応じた推奨BTOモデルを詳しく解説しています。
ローカルLLM・生成AI向けGPUガイドを見るよくある質問
Radeonでは生成AIはできませんか? +
できます。ROCmやVulkanなどを利用し、PyTorch、Ollama、ComfyUIなどをAMD GPUで利用できる環境は広がっています。ただし、対応GPU、OS、アプリ、利用する拡張機能(Custom Nodeや特定ライブラリ)の組み合わせを確認する必要があります。
RadeonでComfyUIは使えますか? +
AMD GPUはComfyUIのサポート対象です。ただしWindows環境などでは一部実験的サポートとなる構成もあり、NVIDIA環境とはインストール手順や利用可能なCustom Node、高速化バックエンドが異なる場合があります。
RadeonでTouchDesignerは使えますか? +
使えます。現在のTouchDesignerはWindowsでRadeon 5000シリーズ以降(RDNAアーキテクチャ)を公式サポートしています。ただしOptical Flow TOPやNVIDIA Background / Denoise / Upscaler TOPなど、NVIDIA GPU専用の機能が存在します。
TouchDesignerを使うならRTXを買うべきですか? +
基本機能やGLSLシェーダー処理が中心ならRadeonでも動作します。しかし、ライブ映像、AI機能(Optical Flow、背景分離、映像ノイズ低減)、H.264/H.265の一部ハードウェア処理、ComfyUI等の生成AIツールとの1台併用まで考えるなら、RTXの方が制作フローに入る制約を減らせます。
ローカルLLMだけならRadeonでも大丈夫ですか? +
利用するモデル、ランタイム(Ollamaなど)、GPUが対応していれば十分に動作します。推論中心の利用であれば実用的な速度が出るケースもありますが、最新の最適化ライブラリや独自学習、画像・動画生成への拡張性を求めるなら依然としてNVIDIA環境が最も選択肢が豊富です。
計算資源の「最上位対決」|民生用フラッグシップとプロ用ワークステーションの境界線
計算資源の「価値・用途」|電力を計算を通じて価値へ変換する。主戦場がAIへ移った背景
計算資源の「所有・利用」|必要なときだけ借りるか、自分の環境として持つか。利用時間・VRAM・総コストから判断する
計算資源の「メモリ構造」|100GB超の大容量ユニファイドメモリと、高帯域なGDDR7専用VRAM。「載る容量」と「動かす速度」を分けて考える
計算資源の「境界線」|「入る」と「速い」の違い、PCIeボトルネックとオフロードの現実
計算資源の「哲学と自由」|買っているのはAIではない、AIを動かす自由だ。所有コストと依存コストの比較
計算資源の「制作フロー」|16GB・32GB・96GBで変わるのは「できること」より「制約の数」
計算資源の「コスト構造」|HBM・パッケージング・半導体製造の逼迫から見るGPU高騰の本質
計算資源の「モデル逆算」|7B〜120Bのモデル規模・量子化・KVキャッシュから必要なVRAM容量を逆算する
計算資源の「持続性」|GPUを動かし続ける電力・冷却・筐体・設置環境を考える
計算資源の「互換性とソフトウェア制約」|GPU性能の数字だけでなく、CUDAとROCm、PyTorch、ComfyUI、TouchDesignerの制作フロー全体からGPUの本当の選び方を整理する
計算資源の「冷却選定」|ローカルLLM用PCを選ぶとき、ケース・エアフロー・空冷・水冷のどこを見るか
計算資源の「共有メモリと購入判断」|Ryzen AI Max+ 395・Mac Studioなど、大容量ユニファイドメモリを使えるPCを用途別に比較する
計算資源の「容量境界とモデル選択」|128GBと192GBで変わるLLMの収容可能性、量子化精度、推論速度、投資判断を整理する。