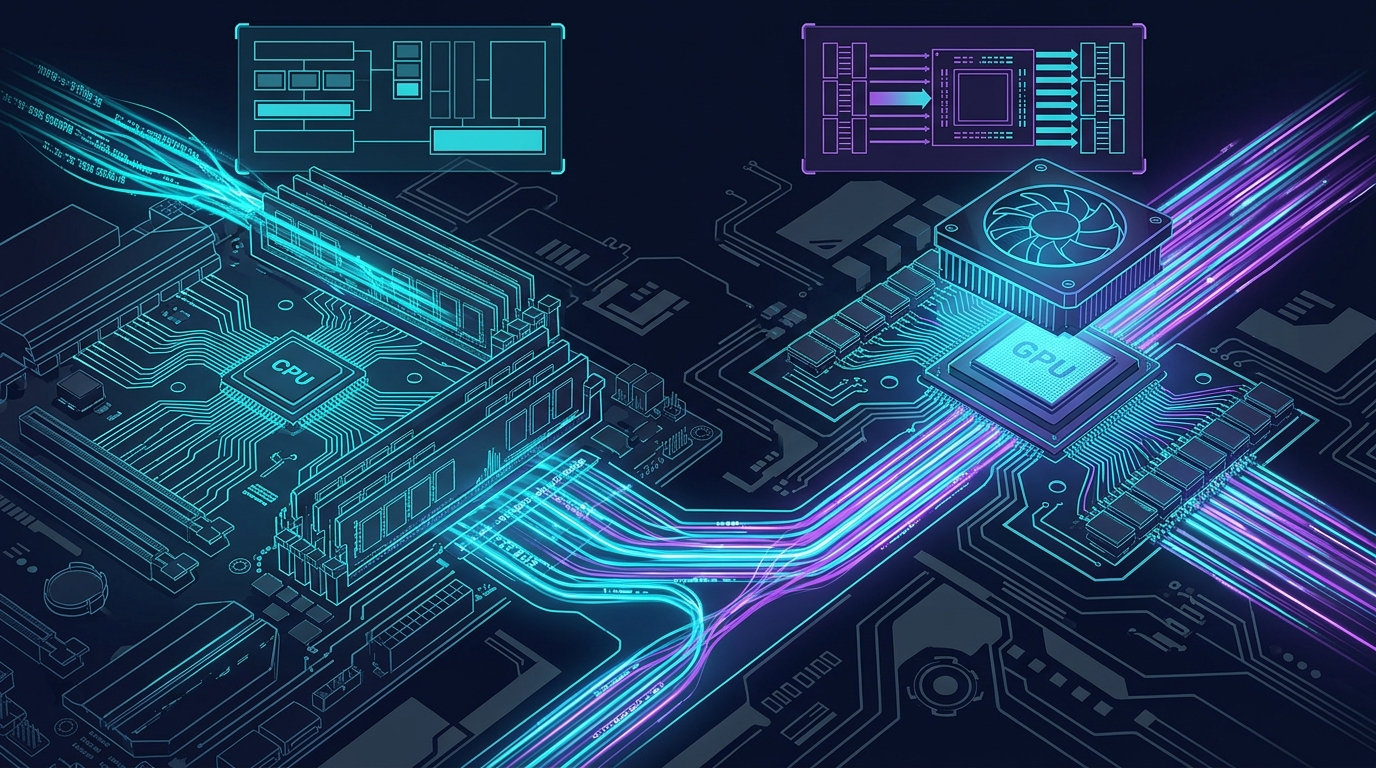
スペック表の数値比較にとどまらず、「計算資源をどう持ち、何に使い、どのような価値へ変換するか」を用途から考えるシリーズです。第5回は、「RAM 128GB積めばVRAM 16GBの不足を補えるか?」という疑問を解剖し、容量・帯域・転送経路の3軸からCPUオフロードの現実とPCIeバスのボトルネックを整理します。
ローカルLLMや画像生成AI、動画生成AIを使おうとすると、必ずと言っていいほど直面するのが「VRAM不足(Out of Memory)」の問題です。
例えば、RTX 5080は16GBのVRAMを搭載しています。そこで、こんな疑問を持つ人も少なくありません。
「PC側のメインメモリ(RAM)を128GB積めば、VRAM 16GBの不足もRAMで補えるのでは?」
実際、AIソフトの中にはGPUのVRAMに入り切らないモデルをメインメモリへ逃がす「CPUオフロード」に対応するものがあります。それなら高価な大容量VRAM GPUを買わなくても良いように思えます。
しかし、ここには大きな落とし穴があります。結論から言えば、メインメモリ(RAM)をいくら増やしても、GPUメモリ(VRAM)の代わりにはなりません。
「モデルが読み込める(入る)」ことと、「実用的な速度で動く(速い)」ことは、根本的に別次元の問題だからです。
本記事では、メモリ帯域・PCIeバスの転送速度・CPUオフロードの現実を、容量・帯域・転送の3つの視点からわかりやすく整理します。
※ただし、PCIeをどれだけ速くしても、VRAMそのものの速度にはなりません。
実践判断|「128GB RAM+5080」vs「64GB RAM+5090」どちらを選ぶべき?
PCを購入・カスタマイズする際、同等の予算で「RAMを特盛にするか」「GPUのVRAMランクを上げるか」で迷うケースがあります。
用途と目的から、明確な判断基準を整理します。
RAM 128GB + RTX 5080(16GB VRAM)
総合制作環境重視・マルチタスク派
- ✅ 3DCGレンダリング・After Effects・動画編集・大量アセット展開が極めて快適
- ✅ 複数アプリを同時に立ち上げてもメモリ枯渇しない
- ⚠️ 16GBを超えるAIモデルや高解像度生成ではオフロードが発生し低速化する
RAM 64GB + RTX 5090(32GB VRAM)
AI処理の高速完結・モデル規模重視派
- ✅ モデルと処理に必要なワーク領域(KV cache・latents等)が32GB VRAM内に収まれば、CPUオフロードを避けてGPU内で高速に処理しやすい
- ✅ VRAM完結時はPCIeバス経由のボトルネックを回避できる
- ✅ 64GB RAMがあれば日常のAI開発や制作でも十分余裕がある
※70B級など、32GB VRAMでも収まらない超巨大モデルでは、量子化(4bit/8bit)やRAMオフロードが必要になる場合があります。
なぜ「RAM 128GBで代用できる」という誤解が生まれるのか?
「RAMを増やせばVRAM不足を解決できる」という誤解が生まれる背景には、2つの現実的な仕組みがあります。
-
① AIフレームワークのCPUオフロード機能:
Hugging FaceのAccelerateやDiffusers、Ollama、llama.cppなど多くのAI実行環境には、GPUのVRAMに入り切らないモデルの一部(または大部分)をメインメモリ(RAM)に退避させて実行する機能が備わっています。 -
② Windowsの「共有GPUメモリ」機能:
WindowsではGPUが必要に応じてシステムRAMを共有メモリとして利用できる仕組みがあります。ただし、これは専用VRAMが増えるという意味ではなく、利用可能量も固定的にRAMの半分が割り当てられるわけではありません。
これらがあるため、「16GB VRAM+128GB RAMなら、大容量モデルもそのまま動かせるのでは?」と期待してしまうのです。
対応するソフトウェアでは、VRAMだけでは入り切らない処理を実行できる場合があります。しかし、そこから先で圧倒的な性能差に直面することになります。
速度差の正体|メモリ帯域幅(Bandwidth)の圧倒的な壁
「入る」と「速い」が全く違う根本原因は、メモリ帯域幅(データを1秒間にどれだけ転送できるか)の桁違いな差にあります。
GPUがAIの行列演算を行う際、数千〜数万の計算コアが一斉にメモリからパラメータを読み出します。このとき求められるのは「容量」ではなく「帯域幅(データの通り道の太さ)」です。
| 規格・ハードウェア | 接続場所・役割 | 公称・理論メモリ帯域 |
|---|---|---|
| GeForce RTX 5090 | GPU専用VRAM (GDDR7) | 約 1,792 GB/s |
| GeForce RTX 5080 | GPU専用VRAM (GDDR7) | 約 960 GB/s |
| Apple M5 Ultra | Unified Memory | 約 1.2 TB/s |
| Apple M5 Max | Unified Memory | 最大 614 GB/s |
| DDR5-5600 (Dual Channel) | PCメインメモリ (RAM) | 約 89.6 GB/s |
| PCIe 5.0 x16 バス | RAM ⇔ VRAM 通信経路 | 約 63.0 GB/s |
| PCIe 4.0 x16 バス | RAM ⇔ VRAM 通信経路 | 約 31.5 GB/s |
※上記は各規格・製品の公称値・理論値を並べた比較です。実際のAI処理速度がこの比率になるわけではありません。
表を見ると一目瞭然です。GPU専用のGDDR7メモリが毎秒1,000〜1,800GBという圧倒的な猛スピードでデータを流し込めるのに対し、PCのDDR5メモリは約90GB/sにとどまります。
さらに深刻なのが、RAMとGPUの間を結ぶPCIeバスのボトルネックです。PCIe 4.0 x16では約31.5GB/s、最新のPCIe 5.0 x16でも約63GB/sしか通りません。
GPUがどれだけ超高速な計算能力を持っていても、データがPCIeという細い経路を通ってしか届かないため、オフロード量や方式によっては、PCIe転送やCPU側処理が律速となり、GPUを十分に使い切れない時間が増えてしまいます。
「入る」と「速い」の違い|CPUオフロードで何が起きるか
では、実際にCPUオフロードを行うとどのような挙動になるのでしょうか。
オフロードの方式や頻度によって、体感速度の低下度合いは大きく異なります。
⚙️ CPUオフロードの主な実行方式
モデルの各層(レイヤー)を1つずつRAMからVRAMへ転送して計算し、計算が終わったら次のレイヤーを読み込む方式。VRAM消費を最小限に抑えられますが、1ステップごとにPCIe転送が発生するため、全体の所要時間は極めて長くなります。
Model Offloadでは、Text EncoderやVAEなどパイプラインを構成するコンポーネントを、必要なタイミングだけGPUへ移します。一方、Group Offloadではモデル内部の複数レイヤーをグループ単位でCPUとGPUの間に移動します。どちらもSequential CPU Offloadより転送・同期回数を抑えやすく、VRAM使用量と速度低下のバランスを取りやすい方式です。
全32層のうち20層をGPU VRAM、残り12層をCPU RAM+CPUコアで分担して計算する方式。GPUだけで完結する場合に比べるとトークン生成速度は低下しますが、VRAMに入り切らないモデルを動かす実用的な手段として広く使われています。
オフロードによる速度低下の幅は、「どれだけのデータ量を、どれだけ頻繁にRAMとVRAMの間で往復させるか」によって劇的に変わります。
1回の処理で数回だけモジュールを入れ替える場合は実用範囲に収まることもありますが、1トークン生成・1ステップごとに毎回復路転送が発生する構成では、VRAM完結時と比べて桁違いに遅くなります。
なぜMacのUnified Memoryは、WindowsのRAMオフロードと違うのか?
「Windows PCでRAMオフロードが遅いなら、なぜMac Studio(M5 Max / M5 Ultra等)は大容量Unified MemoryでローカルLLMを快適に動かせるのか?」という疑問もよく寄せられます。
その理由は、Macのユニファイドメモリアーキテクチャには「PCIeバス」という分離された通信経路が存在しないからです。
Apple Siliconでは、SoC(システム・オン・チップ)の内部にCPUとGPU、そして大容量メモリ(最大128GB〜512GB)が直結されています。
- 帯域幅が極めて広い: 現行Mac Studioでは、M5 Maxが最大614GB/s、M5 Ultraが1.2TB/sのメモリ帯域を持ちます。PCの一般的なDDR5メインメモリ(約90GB/s)より大幅に広い帯域をCPUとGPUで共有できることが、Unified Memoryの大きな特徴です。
- ゼロコピーアクセス: CPUが読み込んだモデルデータをGPUがそのままメモリ内で参照できるため、RAMからVRAMへの「データ転送」そのものが不要。
つまり、Macのメモリは「PCのRAM」ではなく、「GPUのVRAMに近い超広帯域メモリをシステム全体で共有している」構造なのです。
RAMへのCPUオフロードとは別に、Ryzen AI MaxやApple SiliconのようにCPUとGPUが大容量メモリを共有する設計もあります。「速度より、まずモデルをメモリに収めたい」という場合は有力な選択肢です。
128GB級ユニファイドメモリPCの選び方を見る →
目的・課題別の次のステップ
自分のやりたい作業や抱えているボトルネックに合わせて、最適な情報をご確認ください。
※転送帯域・規格値は公式仕様(2026年8月時点)に基づきます。
よくある質問
RAMを128GB積めば、70BモデルのローカルLLMを動かせますか? +
量子化した70B級モデルなどでは128GB RAMで動作可能な構成もありますが、オフロード量が増えるほど速度は低下しやすくなります。70B級をQ4前後でGPU上に収めて実用的な速度を狙う場合は、48GB以上の大容量VRAMが一つの目安となり、余裕を持つなら64GB以上が有力です。32GB級GPUでは、一部をRAMへオフロードして利用する方法があります。
Windowsの共有GPUメモリで画像生成AIは動きますか? +
対応するソフトウェアであれば、VRAM不足時に共有メモリへ退避してクラッシュを回避できる場合があります。ただし、共有メモリへの退避が発生すると生成時間は大幅に悪化します。高速な生成を行いたい場合は、VRAM内にモデルとワークスペースが収まる設定や解像度に調整することが重要です。
PCIe 5.0対応マザーボードならオフロードは速くなりますか? +
PCIe 4.0比で帯域は2倍(約63GB/s)に向上するため、転送のボトルネックは緩和されます。しかし、GPUのGDDR7専用メモリ(1,000〜1,800GB/s)と比べると依然として十数分の一の帯域であるため、VRAMそのものの代わりにはなりません。
Mac Studioならなぜ大容量メモリでAIが速く動くのですか? +
Apple Siliconはユニファイドメモリアーキテクチャを採用しており、CPUとGPUが同一の高帯域メモリを共有します。現行M5 Ultraでは最大1.2TB/sのメモリ帯域を持ち、PCIe経由でRAMからVRAMへ転送する一般的なWindows PCとはメモリ構造が異なります。
AI制作用途ならメインメモリ(RAM)は何GB積むべきですか? +
幅広いAI制作を行うなら64GBは余裕を持ちやすい目安です。ComfyUIの大規模ワークフローや3DCG、動画編集などを同時に行うヘビーユーザーであれば128GBが選択肢となりますが、AI処理そのものの速度向上にはRAM増設よりもVRAM容量の大きいGPUが直結します。
計算資源の「最上位対決」|民生用フラッグシップとプロ用ワークステーションの境界線
計算資源の「価値・用途」|電力を計算を通じて価値へ変換する。主戦場がAIへ移った背景
計算資源の「所有・利用」|必要なときだけ借りるか、自分の環境として持つか。利用時間・VRAM・総コストから判断する
計算資源の「メモリ構造」|100GB超の大容量ユニファイドメモリと、高帯域なGDDR7専用VRAM。「載る容量」と「動かす速度」を分けて考える
計算資源の「境界線」|「入る」と「速い」の違い、PCIeボトルネックとオフロードの現実
計算資源の「哲学と自由」|買っているのはAIではない、AIを動かす自由だ。所有コストと依存コストの比較
計算資源の「制作フロー」|16GB・32GB・96GBで変わるのは「できること」より「制約の数」
計算資源の「コスト構造」|HBM・パッケージング・半導体製造の逼迫から見るGPU高騰の本質
計算資源の「モデル逆算」|7B〜120Bのモデル規模・量子化・KVキャッシュから必要なVRAM容量を逆算する
計算資源の「持続性」|GPUを動かし続ける電力・冷却・筐体・設置環境を考える
計算資源の「互換性とソフトウェア制約」|GPU性能の数字だけでなく、CUDAとROCm、PyTorch、ComfyUI、TouchDesignerの制作フロー全体からGPUの本当の選び方を整理する
計算資源の「冷却選定」|ローカルLLM用PCを選ぶとき、ケース・エアフロー・空冷・水冷のどこを見るか
計算資源の「共有メモリと購入判断」|Ryzen AI Max+ 395・Mac Studioなど、大容量ユニファイドメモリを使えるPCを用途別に比較する