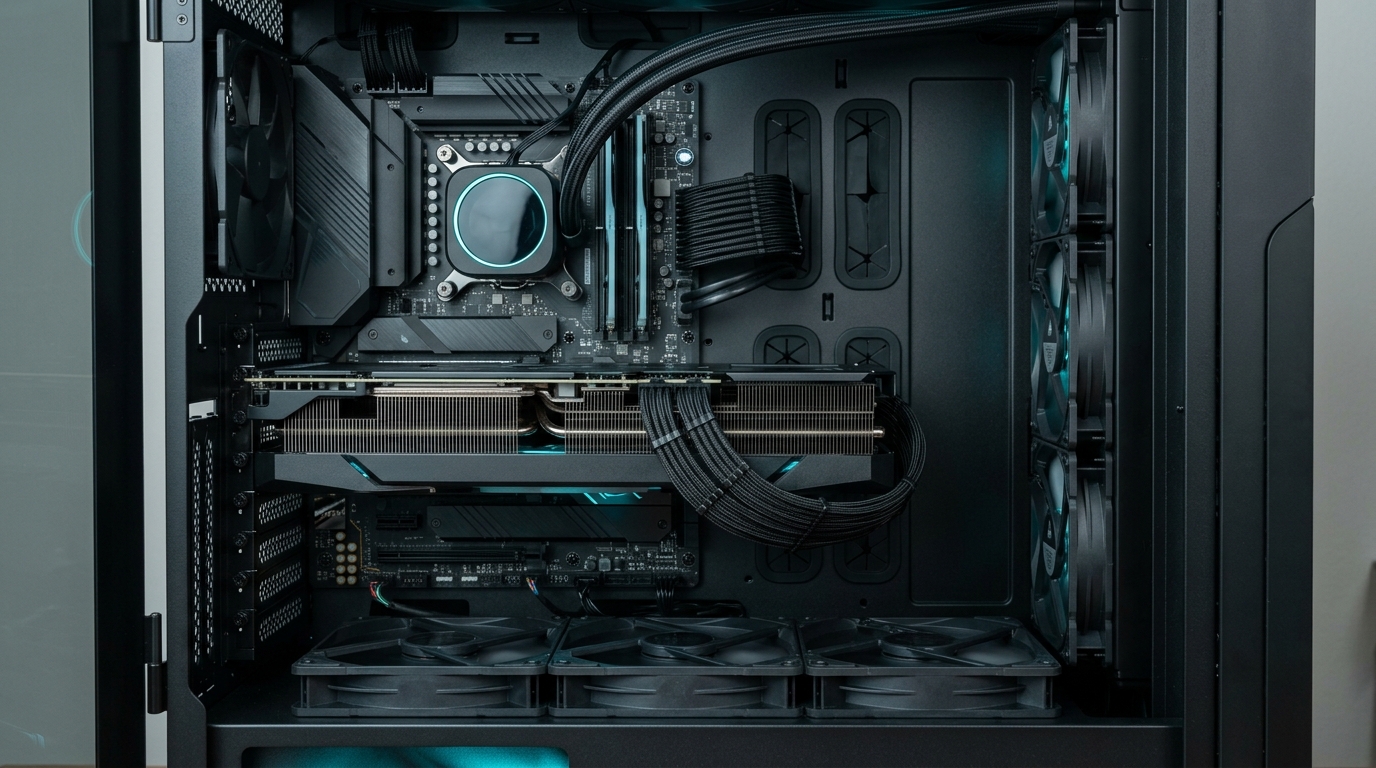
RTX 5090を搭載したデスクトップPCをベースに、さらにAI推論や制作の計算資源を増強したいとき、二つの有力なアプローチが存在します。
一つは、128GBのユニファイドメモリを搭載した独立したAI PCを追加し、LAN経由でタスクを分散する「2台分散構成」。もう一つは、既存のPC筐体内に2枚目のNVIDIA GPU(RTX 5080やRTX 5090)を増設する「同一PC内Dual GPU構成」です。
どちらも計算資源を増強するという目的は同じですが、メモリの扱い(合算されるのか)、NVLink非対応の前提、電源・排熱・PCIeスロットの物理的ハードル、対応ソフトウェアの動作条件は根本的に異なります。本記事では、机上のスペックではなく実用上の実現性から両者を比較します。
目次
1. 30秒で結論:どちらを選ぶべきか?
RTX 5090+UM AIノードを選ぶ人
- 制作とLLM推論を物理的に役割分担させたい
- 大容量共有メモリ(128GB)を必要とする大モデルを常駐させたい
- 既存PCのケース、電源、冷却ファンをそのまま維持したい
- AI推論サービスを別PCで24時間独立稼働させたい
- Windows(制作)とLinux(AI推論)などOS環境を使い分けたい
PC内Dual GPUを選ぶ人
- 追加するGPUでもネイティブなCUDA環境を活用したい
- 2枚のGPUへ別々のCUDAジョブを並列に割り当てたい
- 利用ソフトウェアが明示的にマルチGPU処理に対応している
- 大型フルタワー筐体、十分な電源容量、必要なPCIeレーンを確保できる
- 単一のOSホスト環境で全GPUを一元管理したい
結論:32GBを超える大容量LLMを動かすならユニファイドメモリ機による2台分散運用が合理的です。一方、純粋なCUDA演算力やレンダリング能力を倍増させたいならDual GPUが有力です。ただし、Dual GPUで単一モデルを高速化するには対応ソフト側の分散処理設計が必須となります。
2. 比較する構成
RTX 5090を主軸とし、「別PCへの分業」と「同一PC内へのGPU増設」の代表的なハードウェア諸元を比較します。
| 項目 | 構成A:5090+UM別PC(2台構成) | 構成B:5090+2枚目GPU(同一PC内) |
|---|---|---|
| PC台数 | 2台(制作母艦 + 独立AIノード) | 1台(大型デスクトップ筐体内に集約) |
| 追加演算資源 | UM搭載AI PC(Ryzen AI Max+ 395等) | 2枚目のNVIDIA GPU(RTX 5080または5090) |
| 追加メモリ空間 | 別PCの128GB共有メモリ(最大96GB等) | 2枚目GPUの専用VRAM(16GBまたは32GB) |
| 実行環境 | 独立したOS・推論エンジン(API連携) | 同一ホストOS上でネイティブCUDA利用可能 |
| 接続インターフェース | LANネットワーク(1GbE〜10GbE) | マザーボード上のPCIeスロット(x8/x8等) |
| メモリ容量の統合 | 自動統合されない(独立空間) | 自動統合されない(NVLink非対応) |
| 独立常駐稼働 | 可能(メインPC停止中も稼働維持) | 不可(メインPCの停止・再起動に連動) |
| 主な物理制約 | デスク・設置場所、LAN配線 | 電源容量、筐体内排熱、PCIe厚み |
3. Dual GPUはVRAMが単純に合算されるわけではない
ここはマルチGPUを検討する上で最も誤解が生まれやすいポイントです。
RTX 5090(32GB)にRTX 5080(16GB)を追加した場合、PC内には物理的に合計48GBのVRAMが存在します。しかし、OSや大半のアプリケーションから「単一の48GB GPU」として見えるわけではありません。
同様に、RTX 5090を2枚挿したとしても、自動的に単一の64GB VRAMとして振る舞うことはありません。各GPUは物理的に独立したVRAM空間を持ち、どのデータをどのGPUのメモリに配置するかはアプリケーション側の実装に委ねられます。
NVLink非対応とCUDAマルチGPUの区別:
NVIDIA公式仕様の通り、GeForce RTX 5090 / 5080はハードウェアブリッジである「NVLink」に非対応です。超広帯域でのメモリ統合共有はできません。しかし、CUDA自体は複数GPUへの処理分散に対応しており、対応するAIフレームワーク(vLLM、TensorRT-LLM等)であれば、モデルを層ごとに分割(Pipeline Parallelism)したりテンソルを分割(Tensor Parallelism)して複数GPUで協調動作させることが可能です。
つまり、「自動的にVRAMが足し算されることはないが、対応ソフトウェアを使えば複数GPUを連携させた分散推論は可能」というのが技術的な正確な結論です。
4. UM AIノードを追加する意味
別PCのユニファイドメモリ機をノードとして追加する場合、メインPCのRTX 5090にはグラフィック制作や3Dレンダリング、ゲームなどの主業務に専念させます。
AIノード側では、OllamaやvLLMなどの推論サーバーを立ち上げ、ローカルLLMをメモリに常駐展開します。メインPCからはローカルネットワークのREST API経由でプロンプトを送信し、テキストや制御パラメータを非同期で受け取ります。
この構成最大のメリットは、OSと計算基盤が完全に独立していることです。制作PCがWindowsで頻繁に再起動やドライバー更新を行っても、Linuxで動作するAIノードは停止することなく常駐稼働を続けられます。
注意点として、AIノードの128GB共有メモリはメインPCのVRAMに加算されるものではありません。また、共有メモリのメモリ帯域はRTX 5090の専用GDDR7とは異なるため、トークン生成速度の特性を理解して使い分ける必要があります。
5. Dual GPUが有利になるケース
一方、同一PC内に2枚目のGPUを搭載するDual GPU構成が明確に優位性を持つのはどのような局面でしょうか。
CUDA処理をネイティブに増やしたい
追加する2枚目のGPUがNVIDIA製であれば、成熟したCUDAエコシステムをそのまま利用できます。
例えば、GPU 0(RTX 5090)で動画レンダリングや3D制作を行いながら、GPU 1(RTX 5080等)へ特定のPythonスクリプトやAI推論ジョブを明示的に割り振る運用(CUDA_VISIBLE_DEVICESの指定など)が単一ホスト上で直感的に実行できます。
ソフトウェアが複数GPUに対応している
Blender CyclesやOctane RenderなどのオフラインGPUレンダラーは、複数GPUを同時に認識してレンダリング時間をほぼ線形に短縮できます。
ただし、一般的なゲーム、リアルタイム3Dビューポート描画、多くの動画編集エフェクトは依然として単一GPUしか使用しません。Dual GPUの恩恵は、ハードウェアの存在だけでなく「使用するソフトウェアが複数GPUに対応しているか」に大きく左右されます。
6. 電源・冷却・筐体が大きな判断材料
Dual GPU構成を採用する上で、最大の現実的ハードルとなるのが「電源・排熱・物理スペース」です。
| 構成 | GPU公称TGP合計 | 推奨電源容量 | 必要筐体・配線条件 |
|---|---|---|---|
| 5090+5080 | 575W + 360W = 935W | 個別設計(CPU・AIB・瞬間負荷・メーカー推奨値) | フルタワー筐体、独立12V-2x6ケーブル×2系統 |
| 5090×2基 | 575W + 575W = 1,150W | 個別設計(大容量電源・専用配線検討) | E-ATX対応大型筐体、水冷または強制吸排気設計 |
| 5090+UM別PC | 575W(別PCはSoC単体稼働) | メインPC・AIノードそれぞれ推奨値に準拠 | 既存PCの改造不要。独立した2台として配置 |
※935Wや1,150WはGPU単体の公称TGPを合算した値です。PC全体の必要電源容量は、CPU、AIBカード、瞬間負荷(スパイク電力)、冷却・ストレージ構成、および電源・完成PCメーカーの推奨値から個別に設計する必要があります。高負荷なDual GPU環境や2台構成では、住宅側のブレーカー容量、分岐回路、同一回路上の他機器を確認し、必要に応じて電気工事士などの有資格者へ相談してください。
さらに、近年の大型ハイエンドグラフィックボードは3.5〜4スロット厚を占有します。マザーボード上のPCIeスロット間隔が狭い場合、2枚目を物理的に挿せない、あるいは上段GPUのファンが下段GPUの背面に密着して吸気不能に陥る重大な熱問題が発生します。
7. 用途別の判断
| 主な用途・ワークフロー | 優先構成 | 判断理由 |
|---|---|---|
| 70B+クラス大容量LLMの常時ローカル推論 | UM AIノード追加 | 128GB共有メモリの容量メリットが重要になるため |
| Blender等で複数GPU並列レンダリング | Dual GPU追加 | 対応レンダラーでは複数GPUを利用できるが、スケーリング率はソフト・シーン・構成による |
| 制作母艦と独立してAIサービスを24時間常駐稼働 | UM AIノード追加 | 制作PCの再起動や休止からAIサービスを切り離せるため |
| 対応フレームワークでモデル並列分散を実行 | Dual GPUを検討 | 同一ホスト内の低レイテンシPCIe通信を活用できるため |
| 既存PCの電源・ケース・配線を改造したくない | UM AIノード追加 | LANケーブル1本で接続でき、筐体内部の熱設計変更が不要なため |
| 1台のOSホスト環境で全ジョブをスクリプト管理 | Dual GPU | ネットワーク通信やSSH連携の手間がなく単一環境で完結するため |
8. 費用比較で何を含めるか
増設にかかるコストは、グラフィックボード単体の価格だけで比較してはいけません。周辺インフラを含めた総所有コストの検討が必要です。
UM AIノード追加の費用項目
- 128GB AI PC本体の購入費
- LANスイッチ・Cat6Aケーブルなどのネットワーク機材
- AIモデル格納用SSD
- 追加PCの待機電力
- 設置デスクスペースの確保
※メインPCの電源交換や筐体換装が不要なため、周辺改修コストは極めて小さく済みます。
Dual GPU追加の費用項目
- 2枚目GPU本体の購入費
- 高容量電源ユニットへの換装(必要に応じた容量設計)
- 大型フルタワーケースへの換装・追加ケースファン
- マザーボードのPCIeレーン制約対応(必要に応じた換装)
- 電気配線やブレーカー系統の確認・改修(必要な場合)
※GPU本体代金に加え、電源・筐体・冷却の改修費用が上乗せされる点に注意が必要です。
9. メリット・デメリット
5090+UM AIノード(2台分散)
メリット
- 128GB大容量共有メモリで巨大モデルを展開可能
- 制作PCとAI推論サーバーの完全な独立常駐運用
- メインPC内部の電源・ケース・冷却改造が不要
- 制作環境(Windows)とAI基盤(Linux等)を分離可能
デメリット
- 別PCのGPU演算力はRTX 5090とは異なる
- CUDA専用の特殊ライブラリをそのまま実行できない場合がある
- LAN環境の構築と2台分のOS管理負担が発生する
- 追加メモリは5090のVRAMとして認識されない
同一PC内Dual GPU
メリット
- 追加GPUでも成熟したネイティブCUDAを直接利用可能
- マルチGPU対応ソフトで高い演算並列化を実現
- 全演算資源を単一のPC・OSホスト内で一元管理
- GPU単位で別ジョブを明示的に割り当て可能
デメリット
- VRAMが単一の巨大空間に自動合算されるわけではない
- 公称TGP 935W〜1,150Wに伴う電源・排熱・筐体スペースの制約が大きい
- ソフトウェア側のマルチGPU対応状況に強く依存する
- PCの再起動や停止で全GPUのジョブが同時に停止する
10. 選んではいけない条件
Dual GPU構成を避けるべき条件
利用するソフトウェアが単一GPUにしか対応していない場合、2枚目のGPUを活用できず、発熱と待機電力だけを消費します。また、電源容量不足、ケース内部の熱だまり、ブレーカー容量や配線環境の制約を解決できない環境では避けるべきです。
UM AIノード構成を避けるべき条件
追加したいタスクがNVIDIA独自のCUDAライブラリや特定バージョンに完全依存しており、移行先プラットフォームで推論エンジンが動作しない場合。この場合はどれほどメモリが大きくても実用になりません。
11. 結論:何を増やしたいのかで決める
RTX 5090+UM AIノードは、「独立した別コンピューターを追加して役割を分離する」構成です。
同一PC内Dual GPUは、「1台のホスト内にNVIDIA GPUの並列演算リソースを追加する」構成です。
どちらのアプローチも、単純にGPUメモリを足し算して1つの超巨大GPUを作る手法ではありません。
「大容量メモリを持つ独立したAIノードが必要なのか」、それとも「同一環境でCUDAを担う2枚目のGPUが必要なのか」。増やしたい資源の性質を見極めることで、進むべき構成は明確になります。
よくある質問
RTX 5090を2枚搭載すると64GB VRAMとして使えますか? +
自動的に単一の64GB VRAMとして使えるわけではありません。GPUごとに独立した32GBのメモリ空間が存在します。マルチGPU対応のAI推論フレームワーク(vLLMやllama.cpp等)ではモデルのテンソルやレイヤーを分割配置(Tensor Parallelism / Pipeline Parallelism)して合計64GB分を活用できますが、非対応ソフトや通常の3D・ゲーム用途では単一の巨大VRAMとしては機能しません。
RTX 5090はNVLinkに対応していますか? +
いいえ、NVIDIA公式仕様でNVLink / SLIは非対応と明記されています。ただし、NVLinkがないこととCUDAによるマルチGPU並列処理が不可能であることは別です。PCIeバス経由でのGPU間通信(P2P転送等)に対応したソフトウェアであれば、複数GPUを併用した分散計算が可能です。
RTX 5080を2枚目に追加すれば、どんなアプリも速くなりますか? +
いいえ、高速化するかどうかはソフトウェア側のマルチGPU実装に完全に依存します。一般的なゲームや大半の動画編集・リアルタイム描画ソフトはプライマリGPUしか使用しないため、2枚目を追加しても性能は向上しません。Blender等のマルチGPUレンダラーや、明示的にGPUを指定できるAI推論ジョブで効果を発揮します。
2台構成では10GbEが必要ですか? +
テキスト中心のAPI問い合わせであれば一般的な1GbE(1Gbps)でも十分実用になります。ただし、数ギガバイト規模のチェックポイントファイル転送や、非圧縮画像・動画データを頻繁にやり取りする場合は、10GbEネットワークを導入することで転送待ち時間を大幅に短縮できます。
※仕様、価格、構成は執筆時点のものであり、変更される場合があります。購入・検討前に各社公式サイトをご確認ください。
- NVIDIA GeForce RTX 5090 公式仕様: https://www.nvidia.com/ja-jp/geforce/graphics-cards/50-series/rtx-5090/
- NVIDIA GeForce RTX 5080 公式仕様: https://www.nvidia.com/ja-jp/geforce/graphics-cards/50-series/rtx-5080/
- NVIDIA CUDA Programming Guide (Multiple GPUs): https://docs.nvidia.com/cuda/cuda-programming-guide/03-advanced/multi-gpu-systems.html
- AMD Variable Graphics Memory FAQ: https://www.amd.com/en/blogs/2025/faqs-amd-variable-graphics-memory-vram-ai-model-sizes-quantization-mcp-more.html
🧭 COMPUTE SETUP VS|自分の制作環境に合う構成を選ぶ
Laptop、Desktop、大容量AIノード、RTX PRO。
今のボトルネックと予算に合わせて、最適な計算環境の比較へ進めます。
AIノード併用時、デスクトップ母艦の32GB VRAM投資の意味を判断
RTX 5090単体にAIノードを追加すべき条件を整理
別筐体AIノードか、PC内2枚目GPU増設かの排熱・電源・運用比較
5090+AIノードの分業と、48GB/72GB ECCワークステーション1台構成を比較
5090+AIノードと、84GB ECCを持つPRO 5500のCUDA完結性と構成・役割比較
5090+AIノードと96GB単一GPUワークステーションの構成・業務要件を比較