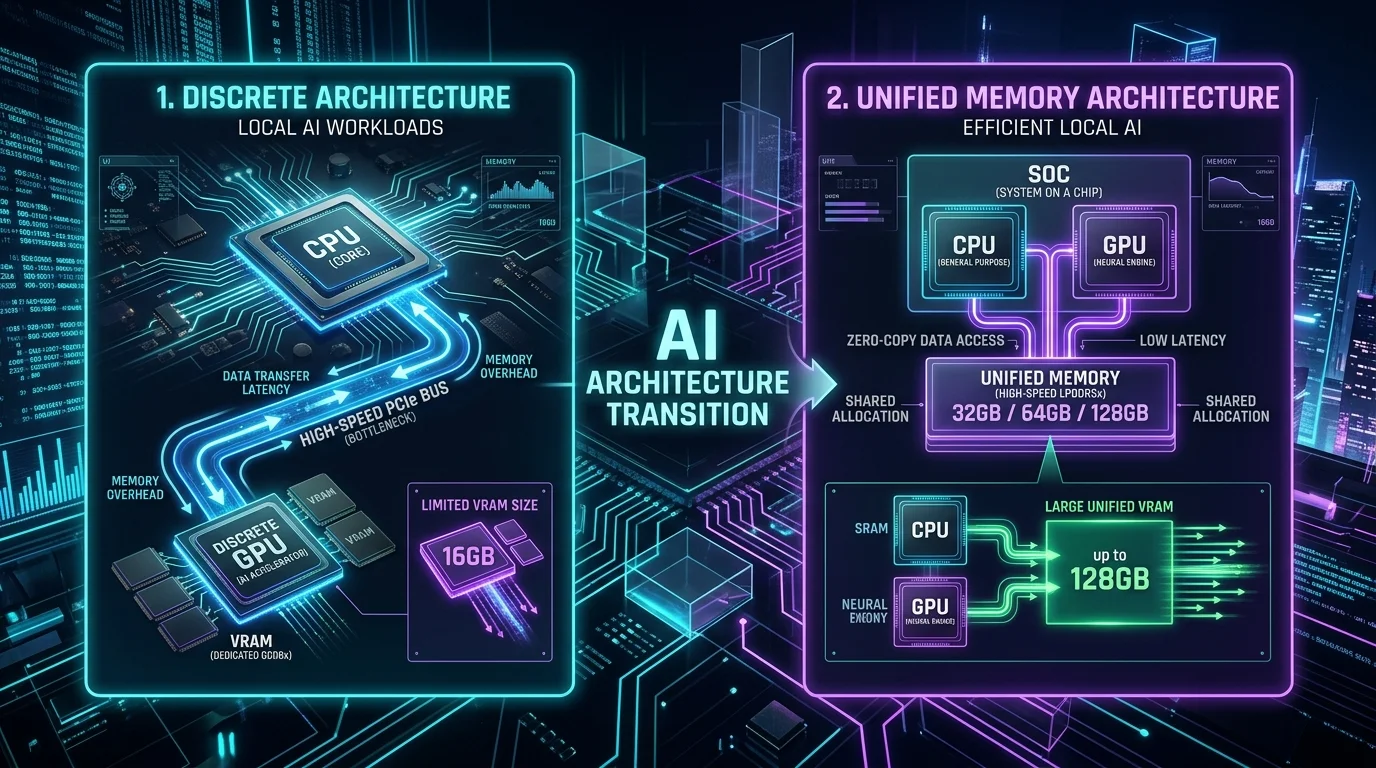
ローカルAI向けのPCを探していると、最近までのPC選びでは少し考えにくかった選択肢が見えるようになりました。
RTX 5090のような高速な専用GPUを搭載したPC。
そして、128GBクラスの大容量メモリ空間をCPUとGPUで共有するPC。
どちらも「AI向けPC」と呼ばれます。
しかし、比べてみると、単純な上位・下位の関係ではありません。
ここで起きているのは、性能競争というよりも、PCを選ぶための前提そのものの変化です。
ユニファイドメモリは、本当にゲームチェンジャーなのでしょうか。
CORE SPECでは、こう考えています。
ゲームチェンジャーになり得る。
ただし、128GBという数字が大きいからではありません。ローカルAIによって、「どれだけ速く計算できるか」だけでなく、
「そもそも処理対象をメモリへ収められるか」
がPC選びの重要な制約になったこと。そこに本質があります。
目次
- 1. 30秒で分かる:何がゲームチェンジなのか
- 2. これまでのPC選びは「どのGPUを買うか」で考えやすかった
- 3. ローカルAIでは「速いか」の前に「入るか」が問題になる
- 4. ユニファイドメモリは「巨大なVRAM」ではない
- 5. ゲームチェンジは「GPU選び」から「アーキテクチャ選び」への変化
- 6. では、RTXは不要になるのか?
- 7. 一台の最強PCから、計算資源を配置するという考え方へ
- 8. 「PCを買い替える」か「計算資源を追加する」か
- 9. Unified Memoryがゲームチェンジャーになる人
- 10. CORE SPECの結論:ゲームチェンジャーなのは「選べる構造」が変わったこと
- 11. 次に進む:自分の場合は何を判断すればよい?
- 12. よくある質問
30秒で分かる:何がゲームチェンジなのか
より上位のGPUを選び、高速に計算させる縦方向の性能アップグレード
どれだけGPUが速くても、必要なモデルやKV CacheがVRAMに収まるかが新たな制約になる
容量・帯域・演算性能・実行環境から、自分の用途に合った計算資源の構造を選ぶ
これまで高性能PCを選ぶとき、中心にあったのはGPU性能でした。
RTX 5070か。
RTX 5080か。
RTX 5090か。
より高速なGPUを選べば、より重い処理を高速に実行できる。
非常に分かりやすい構造です。
しかしローカルLLMでは、別の問題が前に出てきます。
モデルや処理に必要なメモリ容量が、GPUの専用VRAMへ収まるのか。
どれだけGPUそのものが高速でも、必要な処理をそのメモリ空間だけでは扱いにくければ、CPUメモリへのオフロードなど別の方法を考える必要があります。
そこで、大容量の共有メモリを持つアーキテクチャが新しい選択肢になります。
つまり変わったのは、
GPUの性能だけを比較するゲーム
から、
容量・帯域・演算性能・実行環境を組み合わせて、必要な計算資源の構造を選ぶゲーム
への変化です。
これまでのPC選びは「どのGPUを買うか」で考えやすかった
クリエイティブPCやゲーミングPCでは、GPUは非常に分かりやすい判断軸でした。
上位GPUになるほど演算性能が高くなり、画像生成、3DCG、映像処理、リアルタイムグラフィックスなども高速になる。
もちろんCPU、RAM、SSDなども重要ですが、「GPUをどこまで上げるか」がPC全体の方向性を決めるケースは少なくありません。
その世界では、
より強いGPUへ買い替える
という縦方向のアップグレードが合理的でした。
ところがローカルAIでは、必ずしも同じ考え方だけでは整理できません。
ローカルAIでは「速いか」の前に「入るか」が問題になる
ローカルLLMを考えるとき、重要なのは演算速度だけではありません。
モデルサイズ、量子化、コンテキスト長、KV Cache、同時実行するサービスなどによって、必要になるメモリ容量は変わります。
そこで起きるのが、
「この処理を高速に動かせるか?」
より前に、
「この処理をそもそもメモリ空間へ収められるか?」
という問題です。
ここは、従来のGPU性能競争とは少し性質が違います。
たとえばGeForce RTX 5090には、高速な専用GDDR7と強力なGPU演算性能、CUDAを中心とした成熟した実行環境があります。
一方で、Ryzen AI Max+ 395系の大容量共有メモリPCでは、128GBクラスの大きなメモリ空間をCPUとGPUで共有できます。
どちらが「上」なのではありません。
ボトルネックが違います。
高速に計算したいのか。
大きな処理をメモリへ収めたいのか。
ここを分けて考えなければならなくなりました。
→ 詳しくは「128GB共有メモリPCとRTX 5090 32GBはどちらがAI向け?」で、Capacity / Bandwidth / Compute / Ecosystemの4軸から比較しています。
ユニファイドメモリは「巨大なVRAM」ではない
ここは重要です。
128GBのユニファイドメモリを搭載しているからといって、
128GBの高速なGPU専用VRAMを搭載している
という意味ではありません。
CPU、GPU、OS、アプリケーションなどが利用する共有メモリ空間であり、専用GPUのVRAMとは構造も性質も異なります。
そのため、
128GBだから32GBのRTX 5090より4倍強い。
という比較は成立しません。
逆に、
RTX 5090の方がGPUとして高速だから、あらゆるAI処理で優れている。
とも限りません。
だからCORE SPECでは、AI PCを見るときに、4つの軸を分けて考えています。
→ 技術的な仕組みから確認したい場合は「ユニファイドメモリとは?|VRAM・RAMとの違い」を参照してください。
ゲームチェンジは「GPU選び」から「アーキテクチャ選び」への変化
この変化によって、PC選びの問いも変わってきます。
以前なら、
RTX 5080とRTX 5090ならどちらを買うか。
という比較で済んだ場面でも、ローカルAIでは、
高速な専用VRAMを持つRTXを選ぶのか。
大容量共有メモリを持つRyzen AI Maxを選ぶのか。
大容量・高帯域のUnified MemoryとMLX環境を持つMacを選ぶのか。
という比較になります。
つまり、比較しているものがGPU製品だけではありません。
GPUを選ぶ時代から、
計算資源の構造を選ぶ時代へ。
スペック表の数字を競うのではなく、自分のボトルネックを解消する計算アーキテクチャを選択する。
これはかなり大きな変化です。
PCを「スペック表の数字が大きい順」に見るだけでは、正解を出しにくくなります。
- 何を動かしたいのか。
- どれくらいのメモリ容量が必要なのか。
- どの程度の帯域が必要なのか。
- CUDA、MLX、ROCm、Vulkanなど、どの実行環境を必要としているのか。
そこから逆算する必要があります。
では、RTXは不要になるのか?
なりません。
むしろ、役割が明確になります。
画像生成、動画生成、3DCG、リアルタイム処理、CUDAを前提とした制作環境などでは、高速な専用GPUが持つ価値は非常に大きいままです。
大容量共有メモリの存在は、RTXを置き換えるというより、
これまでRTXだけに背負わせていた仕事を、別の計算資源へ分けられるようになった
と考えた方が分かりやすいでしょう。
| RTX制作PCが得意な仕事 | 大容量AI PCが得意な仕事 |
|---|---|
| 画像生成(Stable Diffusion / ComfyUI) | 中〜大規模ローカルLLM(32B / 70B等) |
| 映像制作・VFX・エンコード | 長文・大量資料の解析・RAG検索 |
| 3DCG・Blenderレンダリング | コーディングAI・コードベース全体把握 |
| TouchDesigner・リアルタイム描画 | 常時稼働AIエージェント・バックグラウンド推論 |
| CUDAネイティブな学習・ファインチューニング | 制作環境を止めない並行AI処理 |
こうして整理すると、「どちらを買うか」という二択そのものから離れられます。
一台の最強PCから、計算資源を配置するという考え方へ
ここは、Unified Memoryがもたらす変化の中でも、CORE SPECが特に注目している部分です。
これまでPCのアップグレードは、
今のPCより強いPCへ買い替える
という縦方向の発想が中心でした。
しかし、大容量共有メモリを持つ小型AI PCを追加できるなら、
現在のRTX制作PCを残しながら、AI能力だけを横へ追加する
という構成も可能になります。
PCを増やすこと自体が目的ではありません。
能力を分ける。
制作を担当する計算資源。
思考や検索を担当する計算資源。
データを保存するストレージ。
それらをつなぐネットワーク。
必要な役割に合わせて計算資源を配置する。
AI時代のPC環境は、1台の箱のスペックを競うだけではなく、こうしたシステムとして考える余地が広がっています。
→ 「RTX制作PC+128GB AIミニPCの2台構成は有効?」では、この考え方を具体的なネットワーク構成まで掘り下げています。
「PCを買い替える」か「計算資源を追加する」か
大容量共有メモリPCの中でも、考え方は一つではありません。
たとえばMac Studioのように、
制作、開発、ローカルAIを1台へ統合する
方向があります。
一方、Ryzen AI Max搭載ミニPCのように、
現在使っているWindows PCやRTX制作機を残して、AI用の計算資源を追加する
という方向もあります。
ここでも、
「どちらのベンチマークが上か」
だけでは決められません。
メインPCそのものを置き換えたいのか。
現在の環境へ、新しい能力を追加したいのか。
という判断になります。
→ 「Mac Studio M5 UltraとRyzen AI Max+ 395を比較」では、この違いを「置き換える/追加する」という観点から整理しています。
Unified Memoryがゲームチェンジャーになる人
すべての人にとって、Unified Memoryが必要になるわけではありません。
現在のRTX環境で必要な処理が十分に完結しているなら、無理に変更する理由はありません。
一方で、以下のような用途では、大容量共有メモリという選択肢によって、PC環境の設計そのものが変わる可能性があります。
大切なのは、
Unified Memoryを買うことではありません。
自分の用途で何がボトルネックになっているのかを見つけることです。
容量なのか。
速度なのか。
CUDAなのか。
プラットフォームなのか。
あるいは、一台へ仕事を集中させすぎていることなのか。
CORE SPECの結論:ゲームチェンジャーなのは「選べる構造」が変わったこと
Unified Memoryはゲームチェンジャーなのか。
CORE SPECの答えは、
ローカルAIにおいては、ゲームチェンジャーになり得る。
です。
ただし、その理由は「128GBだから」ではありません。
高速な専用GPUという従来の選択肢に加えて、
大容量の共有メモリを活用するという別のアーキテクチャが、現実的なPC選びの中へ入ってきた。
その結果、
GPUの型番を選ぶ。
という問題から、
自分の仕事に必要な計算資源の構造を選ぶ。
という問題へ、PC選びそのものが広がっています。
だから、これから重要になるのは、
「一番強いPCはどれか」
ではありません。
自分がやりたいことは何か。
その処理は、どこで止まるのか。
そして、そのボトルネックを解消する計算資源は何か。
そこから考える。
Unified Memoryが変えつつあるのは、メモリ容量だけではありません。
PCをどう選ぶか、その考え方です。
よくある質問
Unified MemoryはVRAMの代わりになりますか? +
完全な代替ではありません。共有メモリと高速なGPU専用VRAMでは、容量、帯域、演算性能、実行環境が異なります。用途ごとに判断する必要があります。
128GB Unified MemoryならRTX 5090 32GBより強いですか? +
単純には比較できません。大きなモデルをメモリへ収めやすいことと、高速なGPU演算ができることは別の能力です。
Unified Memoryが普及するとRTXは不要になりますか? +
そのような意味ではありません。CUDA、画像生成、映像、3DCGなど、高速な専用GPUが適している用途は多くあります。大容量共有メモリは別の選択肢を増やします。
今すぐUnified Memory PCへ買い替えるべきですか? +
現在の環境で困っていなければ、必ずしも買い替える必要はありません。まず、自分の処理が容量・速度・実行環境のどこで止まっているのかを確認することが重要です。
※仕様、価格、構成は執筆時点のものであり、変更される場合があります。購入・検討前に各社公式サイトをご確認ください。
🧭 大容量AIメモリ選びの道標
容量、GPU演算、プラットフォーム、実機、配置。
今の迷いに合わせて、必要な判断へ移動できます。
ローカルAIによって、なぜGPU性能だけではPCを選べなくなったのか。PC選びのルールそのものの変化を考える。
VRAM・RAMとの違いと、大容量共有メモリがローカルAIで注目される理由を理解する。
モデルサイズ、コンテキスト、RAG・Agent運用から必要なメモリ容量を判断する。
モデルを収める容量と、高速に計算するGPU性能の違いから判断する。
MLX / macOSか、ROCm・Windows / Linuxか。実行環境とメモリ構成から選ぶ。
完成したAIノードか、OCuLinkで外へ拡張できるAIノードかを判断する。
1台へ集中するか、CUDA制作と大容量AIを別ノードへ役割分担するかを設計する。