150万円の予算がある。
TouchDesignerやUnreal Engine、Unity、Notchなどを使ったリアルタイム制作もしたい。
ローカルLLMやVLMなど、生成AIも本格的に動かしたい。
では、150万円を1台のハイエンドPCに集中させるべきなのか。
それとも、用途の異なる2台に分けるべきなのか。
2026年、ここに新しい選択肢が生まれています。
RTX 5080 Laptopと、128GBクラスのUnified Memory PCを組み合わせる。
「最強の1台」を買うのではありません。
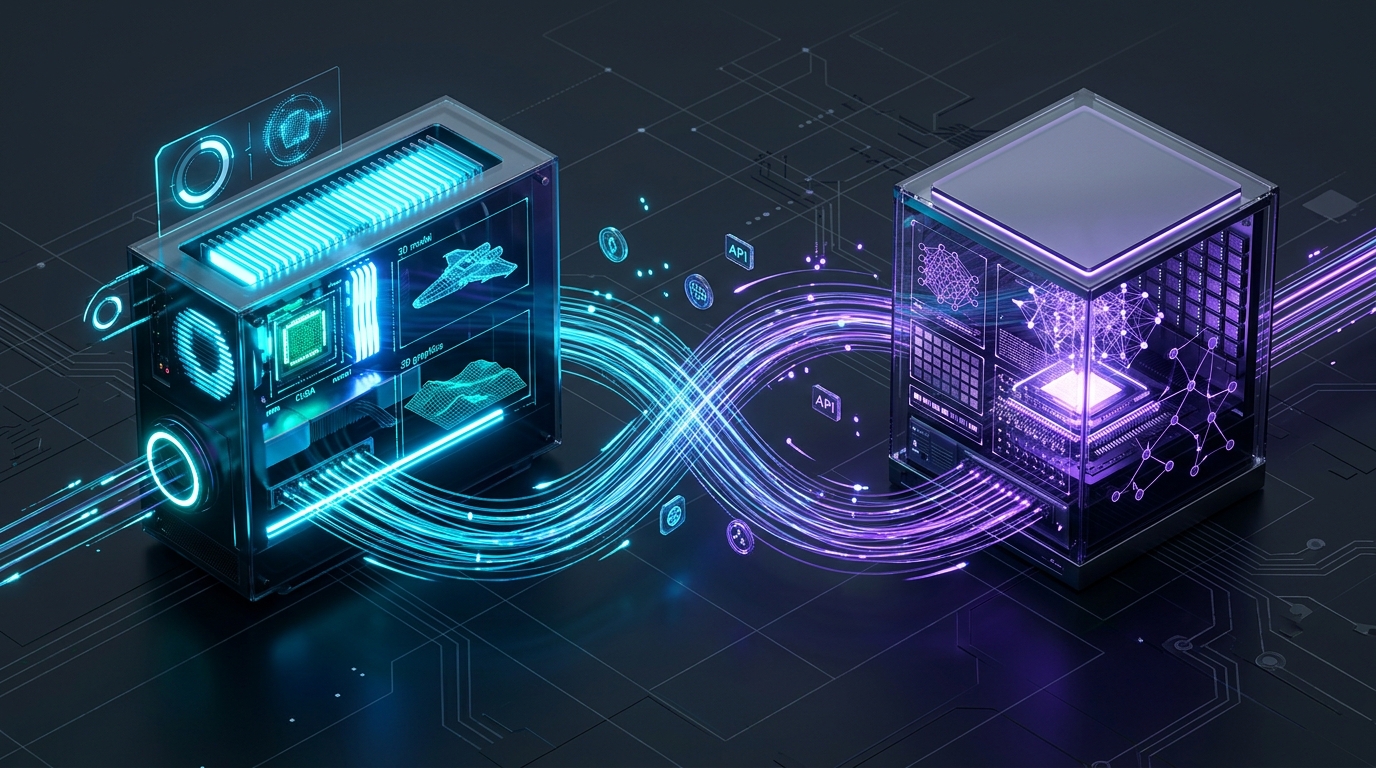
RTXの速さと、Unified Memoryの容量を、それぞれ別のマシンに担当させる。
リアルタイム制作とローカルAIを両方行うなら、これは極めて合理的な構成になってきました。
192GBのEVO-X5 Proという上位ルートもある
192GB Unified Memoryを搭載するGMKtec EVO-X5 Proは、SSDなし早割で1,000,990円(2026年10月6日確認)。RTX 5080 Laptopと組み合わせると約156万円からとなり、150万円の予算を少し超えます。そのため150万円という条件では、RTX側を妥協せず128GB機を選ぶのがスイートスポットになります。総予算を200万円まで拡大できる場合は192GBも有力な選択肢です。
192GBのEVO-X5 Proの解説を見る →最強の1台より、違う強さを持つ2台
リアルタイム制作にはRTXの「速さ」。大規模AIにはUnified Memoryの「容量」。
150万円の予算を単一のPCに集中させるのではなく、異なる計算資源へ配分してポートフォリオを構築します。
30秒で分かる:150万円のスイートスポット
予算150万円で、リアルタイムCG・インタラクティブ制作、CUDAを使う制作環境、ローカルLLM・VLM、大容量モデルの検証をカバーしたいなら、RTX 5080 Laptop + 128GB Unified Memory PCは有力な選択肢です。
RTX 5080 Laptop(約56万円〜)
16GB GDDR7 / 896GB/s / CUDA 7,680基。
TouchDesigner、Unreal Engine、Blender、画像動画生成。現場へ持ち出せる高速な工作機械。
128GB Unified Memory(約60.8万円)
GMKtec EVO-X3 2TB等(Ryzen AI Max+ 395)。
70B〜120B級ローカルLLM、長Context、AI Agent。大容量モデルを展開する巨大な作業机。
残予算を高速外付けNVMe SSD、ディスプレイ、ドック、ネットワーク拡張(EVO-X3標準は2.5GbE。必要に応じUSB4 10GbEアダプタ等)などの制作基盤へ配分できます。
※2026年10月6日時点の実売例。価格・在庫は変動します。
目次
- 1. なぜ1台に150万円を集中させないのか:速度と容量のボトルネック
- 2. RTXは高速な工作機械、Unified Memoryは巨大な作業机
- 3. 【仮定】150万円の予算配分ポートフォリオ
- 4. スペック・役割比較:RTX 5080 Laptop vs 128GB Unified Memory
- 5. 【最重要】「AI生成」の中身によって、予算配分は変わる
- 6. なぜRTX 5080「Laptop」なのか:現場可搬性と役割分担
- 7. 2台をネットワークでつなぐ:API・Agentによるパイプライン
- 8. 【技術的注意】2台構成の目的はメモリ共有ではなく、処理分散です
- 9. 128GB vs 192GBの分岐:150万円と200万円の境界
- 10. 150万円で買うのは「PC」ではなく「計算資源」
- 11. 結論:最強の1台より、違う強さを持つ2台
- 12. NEXT DECISION
- 13. よくある質問
なぜ1台に150万円を集中させないのか:速度と容量のボトルネック
これまでクリエイター向けPCでは、
「予算が増えれば、より強いGPUを積む」
という考え方が基本でした。
しかしローカルAIが日常的な制作に加わったことで、事情が大きく変わってきました。
リアルタイムCGと大規模AIでは、求める計算資源が根本から違うからです。
NVIDIA GeForce RTX 5080 Laptop GPUは16GB GDDR7を搭載し、メモリ帯域は896GB/s。CUDAコアは7,680基あります。
TouchDesigner、Unreal Engine、Unity、Notch、Blender、映像処理などでは、この「圧倒的に高速なGPU」が不可欠です。フレームレートを落とさず、低遅延でレンダリングするためにはGPU速度が正義です。
しかし、AIモデルが16GBに収まらなくなった瞬間、GPUがどれだけ速くても別の問題が生まれます。
「モデルが載らない」という容量の壁です。
ここでは速度ではなく、容量(VRAMサイズ)が絶対的なボトルネックになります。
メインメモリ(DDR5)へのオフロードを行うと、PCIe帯域の制限によって推論速度は急落します。詳しくはRAMとVRAMオフロードの違いで解説していますが、速度特化のGPUに大容量モデルを押し込むのは無理が生じるのです。
RTXは高速な工作機械、Unified Memoryは巨大な作業机
Unified Memory(統合メモリ)は、RTXとはまったく違う問題を解くために作られています。
たとえばGMKtec EVO-X3は128GBのLPDDR5X Unified Memoryを搭載しています(GPUへの割当可能量は機種・BIOS設定によるため最新仕様を確認。同系統のEVO-X2 128GB版では最大96GBと公式明記)。
さらに最上位のEVO-X5 Proでは192GB LPDDR5X-8533を搭載し、最大160GBを動的に割り当てられます。メモリ帯域は最大273GB/sです。
もちろん、273GB/sとRTX 5080 Laptopの896GB/sを単純に比較して「どちらが上か」と考えるべきではありません。
役割がまったく違うからです。
高速な「工作機械」
非常に高速な回転数で材料を削り出す工作機械。画像生成、動画生成、CUDA処理、リアルタイムレンダリングを瞬時に処理するが、材料置き場(16GB)は小さい。
巨大な「作業机」
巨大な設計図や資料を広げられる作業机。巨大なLLM、VLM、長いContext、複数のAI Agentなど、通常のGPU VRAMでは置ききれないものをまるごと展開できる。
工作機械を巨大化しても、作業机が小さければ扱えないものがあります。
逆に、巨大な作業机があっても、高速な工作機械の代わりにはなりません。
そこで、「大きな作業机」と「高速な工作機械」を両方持つ。
これがRTX+Unified Memoryという2台構成の基本思想です。
【仮定】150万円の予算配分ポートフォリオ
ここで具体的なシミュレーションを行ってみましょう。
予算は150万円。用途は次の2つです。
- リアルタイム制作:TouchDesigner、Unreal Engine、Unity、Notch、Blender、映像出力、インタラクティブコンテンツ
- ローカルAI:LLM、VLM、AI Agent、RAG、大きなContext、常時稼働ローカル推論
この条件なら、すべてを1台に集中させる必要はありません。
150万円を「1台のスペック」に変えるのではなく、「計算環境全体へ投資する」という視点でポートフォリオを組みます。
| 配分先 | 想定ハードウェア | 想定金額 | 配分比率 |
|---|---|---|---|
| NODE 1:リアルタイム制作 | RTX 5080 Laptop(16GB GDDR7 / 896GB/s) | 約560,000円〜 | 約37.3% |
| NODE 2:大容量AI推論 | GMKtec EVO-X3 128GB/2TB(Ryzen AI Max+ 395) | 約607,999円 | 約40.5% |
| 周辺環境・基盤投資 | 高速外付けNVMe SSD / モニター / ドック / ネットワーク拡張(必要に応じ10GbE化) | 約332,001円 | 約22.2% |
| 合計(予算枠) | 2台構成+高速ネットワーク基盤 | 1,500,000円 | 100.0% |
スペック・役割比較:RTX 5080 Laptop vs 128GB Unified Memory
2台の性格の違いを理解するために、主要な指標を比較します。
重要なのは、「どちらが優れているか」という○×判定にしないことです。
RTX=速度、Unified Memory=容量という「違う役割」を整理します。
| 比較項目 | RTX 5080 Laptop | 128GB Unified Memory PC |
|---|---|---|
| 主な得意分野 | リアルタイム処理・高速描画・CUDA | 巨大データ・大規模LLM/VLM展開 |
| GPU計算速度 / 帯域 |
896GB/s(16GB GDDR7) CUDA 7,680基(極めて高速) |
最大273GB/s(LPDDR5X-8533) Radeon 8060S(中速・容量重視) |
| メモリ容量(AI利用可能枠) | 16GB(速度特化・容量制限あり) | 128GB Unified Memory(割当量は機種・BIOS依存 / X2は最大96GB明記) |
| リアルタイムCG(TouchDesigner/UE) | 最適(高フレームレート・低遅延) | 不向き(内蔵GPUのためリアルタイム重描画は限定的) |
| CUDA依存処理 | ネイティブ完全対応(最高効率) | ROCm/DirectML/Vulkan等に限定 |
| 画像・動画生成(FLUX / SD) | 16GB内に収まるCUDA最適化処理で極めて高速 | 速度は劣るが16GB超の大型モデルでも載る容量優位性 |
| LLM / VLM(大規模推論) | VRAM内完結は8B〜14B級を扱いやすい(大型モデルも量子化・オフロードで実行可能だが容量余裕は小さい) | 70B〜120B級を1台で展開・常駐可能 |
| 長Context・AI Agent | KV Cache肥大によるVRAM溢れが発生 | 広大なメモリ空間により長文推論が余裕 |
| 可搬性・設置スタイル | Laptop(現場・展示・スタジオへ移動可能) | ミニPC(有線LAN固定・常時稼働AIサーバー) |
| 主なシステム上の役割 | メイン制作機・現場機・高速描画ノード | ローカルAIサーバー・大容量推論ノード |
【最重要】「AI生成」の中身によって、予算配分は変わる
ここは本記事においてもっとも注意すべき判断分岐です。
「AI生成」と言っても、すべての生成処理が同じ計算資源を求めているわけではありません。
「AIだからUnified Memory」と一般化してはいけません。
自分が必要としているAI処理が「速度」を求めているのか、それとも「容量」を求めているのかによって、予算を配分すべき先は正反対になります。
LLM / VLM / AI Agent / 長文Context
テキスト生成、コード解析、RAG、マルチモーダルVLM、数十万トークンのContext処理、常時稼働エージェントなど。
Stable Diffusion / FLUX / 動画生成 / 3D
ComfyUIによる画像生成、FLUX.1、動画生成モデル、NeRF/3D Gaussian Splatting、CUDA密結合の制作ワークフローなど。
もし自分の用途が「FLUXや動画生成AIを高速に何百枚も回すこと」であれば、128GBのUnified Memory機に60万円を割くよりも、RTX 5090クラスを搭載したハイエンド1台に予算を集中させた方が満足度は高くなります。
逆に、「TouchDesignerで映像を作りながら、ローカルで70B級のLLMやAgentに常に相談・コード生成・制御をさせたい」のであれば、この2台構成は無類の威力を発揮します。
なぜRTX 5080「Laptop」なのか:現場可搬性と役割分担
ここではあえてデスクトップPCではなく、Laptop(ノート型)を想定しています。
リアルタイム制作において、性能と同じくらい、あるいはそれ以上に価値を持つのが「現場へそのまま持って行けること」だからです。
- アート展示・メディアインスタレーションの現地セットアップ
- ライブパフォーマンス・ステージ演出の現場オペレーション
- プロジェクションマッピングの現場調整・キャリブレーション
- クライアントオフィスでのリアルタイムデモや撮影現場
リアルタイム系の制作では、制作環境そのものを現場へ持ち込むケースが多々あります。
Unified Memory PCを自宅やオフィスのAIサーバーとして固定設置し、RTX Laptopを制作・現場オペレーション機として持ち出す。
そう考えると、2台の役割分担は一段とクリアになります。
同じRTX 5080 Laptop GPUでも、筐体サイズやメーカーのTGP(Total Graphics Power)設定、冷却機構によって実際の実行性能は異なります。据え置き型デスクトップRTX 5080とはCUDAコア数や消費電力枠が異なるため、純粋な据え置き絶対性能のみを求める場合はデスクトップBTOも選択肢に入ります。
2台をネットワークでつなぐ:API・Agentによるパイプライン
さらに重要なのは、この2台を「バラバラの独立したPC」として孤立させる必要がないことです。
2台を有線LANで接続し、Unified Memory機をローカルAI推論サーバーとして運用します。
たとえば、LM StudioやOllama、vLLMなどをUnified Memory機でバックグラウンド実行し、OpenAI互換のローカルAPIサーバーとして開放します。
RTX Laptop側からは、TouchDesignerのPythonスクリプトやUnreal Engine、エディタ(Cursor / Claude Code等)からネットワーク越しにそのAPIを呼び出します。
一方、数十GBに及ぶモデルファイルや映像素材、巨大データセットを2台間で頻繁に移すなら、USB4 10GbEアダプター等の追加による10GbE化を残予算から検討するのが合理的です。
128GB Unified Memory PC
大規模LLM / VLM / AI Agent / RAGサーバー。
LM StudioやOllamaでローカルAPIサーバー(:1234)を常時稼働。
RTX 5080 Laptop
TouchDesigner / Unreal Engine / CUDA / リアルタイム映像出力。
有線LAN(2.5GbE / 10GbE)経由でAIノードへプロンプト送信・制御パラメータ受信。
このような連携によって、次のようなパイプラインが組めます。
- Unified Memory PCが大規模LLMでユーザー入力やセンサーデータを推論
- リアルタイム演出のパラメータやシェーダーコードを生成
- ネットワーク越しにRTX Laptopへ処理要求を送信
- RTX LaptopがCUDAと16GB GDDR7の超高速描画で即座にレンダリング・映像出力
- 描画結果やログをUnified Memory側のAI Agentへフィードバック
これは単に「PCを2台並べた」という話ではありません。
異なる特徴を持つ計算ノードを組み合わせるという発想です。
個人の制作環境が、小さなコンピュートクラスターになっていくのです。
【技術的注意】2台構成の目的はメモリ共有ではなく、処理分散です
ここは非常に誤解しやすい点であり、明確にしておく必要があります。
Unified MemoryをRTXの外部VRAMとして使えるわけではありません
128GBや192GBのUnified Memory PCとRTX Laptopを有線接続したからといって、「RTX 5080のVRAMが128GBになる」わけではありません。
RTXがリアルタイム描画やComfyUIで使うVRAMは、あくまでRTX自身が基板上に搭載する16GBのGDDR7です。ネットワーク越しにVRAM空間を仮想的に合算(VRAM Pooling)して単一GPUのように扱うことはできません。
したがって、この構成の本質は「メモリを共有すること」ではなく、「処理を分担すること」にあります。
詳しくは2台構成の運用設計やサーバー構築など技術面を掘り下げたRTX制作PC+128GB AIミニPCの2台構成解説でも述べていますが、制作処理(RTX)とAI推論(Unified Memory)を物理的に分離することで、AI推論によるVRAM消費を避け、RTXのVRAMをリアルタイム制作に専念させられることこそが最大のメリットです。
128GB vs 192GBの分岐:150万円と200万円の境界
大容量共有メモリの世界では、2026年秋に登場したGMKtec EVO-X5 Pro(192GB)が大きな話題を集めています。
では、今回の150万円予算において、192GBは選択肢に入るのでしょうか。
| 比較軸 | 128GB構成(EVO-X3等) | 192GB構成(EVO-X5 Pro) |
|---|---|---|
| AI機本体価格(実売例) | 約607,999円(128GB+2TB) |
早割 約1,000,990円(192GB SSDなし) 早割 約1,055,840円(192GB+2TB) |
| RTX 5080 Laptopとの合計 | 約116.8万円〜(予算内) | 約156万円〜(150万円超過) |
| 150万円予算での成立性 | ◎ スイートスポット(残予算約33万円) | × 予算オーバー(RTX側を妥協する必要あり) |
| 対応可能なローカルLLM規模 | 70B(Q4〜Q6) / 120B級 | 最大320B公称(複数モデル常駐・特大Context) |
| 適正な総予算枠 | 総予算 130万〜150万円 | 総予算 180万〜200万円以上 |
結論として、150万円という予算枠を厳守するなら、128GB構成が最も美しいバランスになります。
192GBのEVO-X5 Proは確かに魅力的ですが、本体だけで約100万円を超えてしまうため、RTX 5080 Laptop(約56万円〜)と合わせると150万円を突破してしまいます。
もし150万円で192GBを入れようとすると、RTX側をRTX 5070 Laptopへ落とすなどの妥協が必要になり、リアルタイム制作の性能を犠牲にしてしまいます。
「150万円なら、まず128GBを選び、RTX側を妥協しない」
これが現在の価格環境における合理的な境界線です。逆に、予算を200万円まで拡大できるのであれば、RTX 5080/5090 Laptop + 192GB Unified Memoryという究極の2台構成が現実味を帯びてきます。
150万円で買うのは「PC」ではなく「計算資源」
今回のシミュレーションから見えてくるのは、PC選びそのもののパラダイムシフトです。
これまでは、
- ・CPUは何を選ぶか
- ・GPUは何を選ぶか
- ・RAMは何GB積むか
という「1台のパソコンのスペック」だけを考えていました。
しかし生成AIが制作現場に組み込まれた現在、リアルタイム描画、CUDA高速演算、大容量LLM推論、常時稼働AI Agent、高速ネットワーク、大容量NVMeストレージといった多面的な要素を、無理に1台の筐体へ押し込む必然性はありません。
重要なのはPC単体のスペックではなく、「自分が日常的に使える計算資源全体をどう設計するか」というアーキテクチャの視点です。
結論:最強の1台より、違う強さを持つ2台
150万円あるから、150万円のPCを1台買う。
その発想は、これから少しずつ変わっていくかもしれません。
リアルタイムにはRTXの「速さ」。大規模AIにはUnified Memoryの「容量」。
そして有線LAN(テキストAPIなら2.5GbEで十分、大容量転送なら10GbE化)で両者をつなぐ。
リアルタイム制作とローカルAIを両立させたいクリエイターにとって、この2台構成は2026年時点で極めて洗練された「150万円の使い方」の一つです。
最強のPCを1台探すのではなく、自分に必要な計算資源のポートフォリオを設計する。
PC選びは、そんな新しいステージに入りつつあります。