「NVIDIAのCUDAが動き、しかも最大128GBのユニファイドメモリを積めるなら、もう巨大なRTX 5090デスクトップも、Ryzen AI Maxも、Mac Studioも必要ないのではないか?」
2026年10月、NVIDIAのArm SoCプラットフォーム「RTX Spark(NVIDIA N1X / N1)」を搭載したノートPCや小型デスクトップの実機レビューと国内価格が出揃い、ローカルAI開発者やクリエイターの間で大きな注目を集めています。これまで「CUDAのソフトウェア資産を取るなら32GB VRAMのRTX 5090まで」「64GB〜128GB超の大容量共有メモリを取るならApple Silicon(Metal/MLX)かRyzen AI Max(ROCm/Vulkan)」という明確なトレードオフが存在していたからです。
しかし、公開された実機ベンチマークやNVIDIA公式のUMA(Unified Memory Architecture)開発者仕様書、各ソフトウェア開発元の公式見解を精査すると、「最大128GBの共有メモリ+CUDAがあるから、既存のハイエンドPCをすべて1台で代替できる」という単純な話ではないことが見えてきます。
なぜなら、実際の業務を置き換えようとした瞬間、①メモリ帯域と演算規模の壁(約273〜301GB/s vs 1,792GB/s)、②Windows 11 on Armのアプリ・プラグイン互換性の壁、そして③UMAの3領域分割(GPU専用carveout/共有領域/CPU専用領域)と動的メモリ予算の壁という3つの現実的な制約に直面するからです。
本記事では、2026年10月15日に公開された海外主要メディアの実機検証データと、NVIDIA公式技術資料・Derivative(TouchDesigner)・SideFX(Houdini)・Adobe等の一次情報を照合し、RTX Sparkが既存の3大環境(RTX 5090/Ryzen AI Max/Mac Studio)の代わりになる領域・ならない領域を8つの実務ワークフロー別に判定します。
RTX Sparkは「万能な上位互換」ではなく、「CUDA対応の大容量モバイル/省電力AI開発機」
| ◎ 代替できる領域 | 8B〜32B級のローカルLLM推論・ローカルRAG・AIエージェント開発・WSL2(Linux Arm64)上のCUDAプロトタイピング、および8GB〜12GB VRAM機ではメモリ不足に陥りやすいモバイル映像編集・中量級ComfyUI検証。 |
|---|---|
| ✕ 代替できない領域 | RTX 5090 Desktopが担う高速レンダリング・大量の動画生成・高フレームレート3DCG制作(メモリ帯域は約6分の1、ラスタライズGPU性能はRTX 5070 Laptop相当)、およびTouchDesigner・Notch等のx86_64前提リアルタイム映像・VJ本番運用。 |
| △ 条件付きで競合する領域 | 70B〜120B級の超大規模LLM常駐。64GB〜128GB構成ではGPU専用carveout+共有領域(post-carveoutの50〜80%)により単一マシンへ収容可能ですが、メモリ帯域(約273〜301GB/s)の制約から、トークン生成速度では広帯域なMac Studio(M5 Max:460GB/s・上位614GB/s、M5 Ultra:1.2TB/s)が明確に優位です。 |
TABLE OF CONTENTS|目次
1. 結論:RTX Sparkが代替できる領域・できない領域
最初に、実務における結論を整理します。RTX Spark(NVIDIA N1X)が従来のGeForce RTX 5090(32GB専用VRAM)、Ryzen AI Max+ 395 / PRO 495(最大128GB〜192GB共有メモリ)、Mac Studio(現行M5 Max / M5 Ultra世代・最大128GB〜512GBユニファイドメモリ)の代わりになるかどうかは、「どの作業を主軸にするか」によって明確に分かれます。
| 実務ワークフロー(A〜H) | RTX Spark (N1X) 24〜128GB / Win on Arm |
RTX 5090 Desktop 32GB GDDR7 / x86_64 |
Ryzen AI Max 128〜192GB / x86_64 |
Mac Studio (M5世代) 36〜512GB / macOS |
|---|---|---|---|---|
| A-1. ローカルLLM推論 (8B〜32B・高速応答重視) |
◎ 有力な代替候補 8Bで約49〜56 t/s。モバイル機として低遅延(TTFT 0.27〜0.39秒)で実用的。 |
◎ 最速(基準機) 1,792GB/sの帯域で圧倒的な生成速度。ただし単体32GBが上限。 |
○ 実用的 容量余裕は大きいが、Prompt処理(TTFT)はCUDA勢が優位。 |
◎ 高速・静音 M5 Max(460/614GB/s)・M5 Ultra(1.2TB/s)の広帯域とMLXで快適。 |
| A-2. 大規模LLM推論 (70B〜120B・長文文脈) |
△ 条件付き代替 128GB構成のUMA(carveout+共有最大80%)で収容圏内。ただし帯域約273〜301GB/sが速度上限。 |
✕ 単体VRAM不可 32GBを超えるためCPU RAMオフロードで急減速。 |
◎ コスパ優位 最大96GB〜128GB超のGPU割当(VGM)で70B〜120Bを収容可能。 |
◎ 最有力(基準機) M5 Ultraで1.2TB/s・最大512GBまで対応し、70B超の実用速度が最高峰。 |
| B. AIエージェント・RAG (ローカル推論/クラウド併用) |
◎ 代替可能(強み) ローカルLLM/RAG実行にCUDA+大容量UMAが直結。Docker/IDE多重起動も余裕。 |
○ 高速だが高消費電力 ローカル応答は最速だが、常時待機ノードとしては電力・排熱が重い。 |
◎ 据え置きノード向き x86_64 Docker/Linux資産がそのまま動き、常駐サーバーに最適。 |
◎ 開発母艦として定番 UNIX系開発環境と大容量メモリの親和性が非常に高い。 |
| C. ComfyUI・画像/動画生成 (Flux・Wan・長尺動画AI) |
△ 試作・容量突破は可 WSL2経由でCUDA拡張互換を確保可。OOMは防げるが生成速度はRTX 5090と大差あり。 |
◎ 代替不可の主戦場 演算規模・帯域・x86カスタムノード互換のすべてで圧倒的。 |
△ 速度・ROCm制約 大容量モデルは載るが、CUDA専用ノードや動画生成速度で不利。 |
△ 速度・CUDA非対応 MPS対応は進むが、最新動画生成モデルの試行回転数ではRTX優位。 |
| D. 3DCG・ゲームエンジン (Blender / UE5 / Houdini) |
△ モバイル補助止まり BlenderはArm版あり。HoudiniはWindows Armネイティブ版なし(エミュレーション見込み・GPU機能未確認)。 |
◎ 制作の本命 OptiX・Lumen・Karma XPU・Redshiftをフル性能で実行可能。 |
○ CPU+大容量は堅実 x86_64互換は高いが、OptiX専用レンダラではNVIDIAに劣る。 |
○ Metal対応ソフトで強み Blender Metal等は高速だが、UE5 VRやNVIDIA専用機能は制約あり。 |
| E. リアルタイム映像・VJ (TouchDesigner / Notch / Resolume) |
✕ 現時点で代替不可 TouchDesignerは公式ネイティブ非対応(開発元が社内Arm機でmimalloc.dll等を調査中)。現場投入は不可。 |
◎ 現場・展示の標準 Spout、NDI、各種センサーSDK、Optical Flow等が完全動作。 |
△ 軽〜中規模まで x86_64のためTD等は起動するが、NVIDIA専用TOPは非対応。 |
◎ Apple Siliconネイティブ TouchDesigner / ResolumeのmacOS Armネイティブ実績が豊富。 |
| F. 映像編集・グレーディング (Premiere / AE / DaVinci) |
○ モバイル編集機として有力 DaVinci・PremiereのArm64版が動作。大容量UMAが高解像度RAWで有利だがx86プラグインは要注意。 |
◎ 重いVFX・書き出し最速 サードパーティ製プラグイン互換とGPUエフェクト速度が盤石。 |
○ プラグイン互換良好 x86_64 Windows資産をそのまま使いつつ大容量RAMを活用可能。 |
◎ 映像業界の定番母艦 ProRes Media EngineとM5世代のCPU/GPU性能で極めて快適。 |
| G. ゲーム・リアルタイム描画 | △ 補助用途まで GPU基礎体力はRTX 5070 Laptop相当。x64エミュレーションの約20%負荷とアンチチート非対応に注意。 |
◎ 4K最高設定・基準機 互換性・フレームレート・レイトレーシングすべて最高峰。 |
○ フルHD〜WQHD堅実 x86_64ネイティブのためアンチチート問題が起きにくい。 |
✕ ゲーム目的には不向き macOS非対応タイトルが多い。 |
| H. 既存RTX制作PCの 「AI専用2台目」 |
◎ 非常に相性が良い メイン機のCUDA環境とコードを揃えつつ、大容量AI+モバイル開発機を増設できる。 |
(メイン制作機側) | ◎ 据え置き2台目の本命 画面なしの常駐AIミニPCノードとして導入コストが最も優秀。 |
◎ 大規模推論サーバー 70B〜120B超の高速APIサーバー兼サブ制作機として強力。 |
なぜ「最大128GB+CUDA」でも万能な1台にはならないのか? ── 3つの壁
RTX Sparkを正しく評価するためには、「ユニファイドメモリ最大128GB」と「CUDA対応」という2つの言葉の間にある3つの物理的・アーキテクチャ的な壁を分解して見る必要があります。
① 速度と帯域の壁
RTX Sparkのメモリは256-bit LPDDR5X(帯域約273〜301GB/s)、GPUは最大6,144 CUDAコアです。デスクトップRTX 5090(1,792GB/s・21,760コア)と比べるとメモリ帯域は約6分の1、演算コア数は約3.5分の1であり、32GB以内に収まる処理の速度ではRTX 5090の代わりになりません。
② Arm互換性の壁
GPUがCUDAに対応していても、CPU命令セットはArm64(Windows 11 on Arm)です。x86_64前提のクリエイティブソフト、サードパーティ製プラグイン、特殊メモリアロケータ(mimalloc.dll等)、ハードウェアドングルはそのまま動かないケースがあります。
③ UMA 3領域分割と動的予算の壁
物理128GBの100%をGPUだけで占有できるわけではありません。RTX SparkのUMA仕様では物理メモリを①GPU専用carveout、②共有領域(post-carveoutの50〜80%)、③CPU専用領域に分割して管理するため、構成やCPU負荷に応じて実効GPUメモリ予算が変動します。
2. RTX Spark(N1X)のUMAメモリ仕様と、4つの計算環境の6軸比較
2026年10月に実機が登場したNVIDIA RTX Spark(SoC名:NVIDIA N1X / N1)は、最大20コアのArmv9.2 CPU(Cortex-X925×10+Cortex-A725×10、下位構成は18コア)と、Blackwell世代のGPU(最大48 SM / 6,144 CUDAコア、下位構成は5,120コア / 第5世代Tensorコア / 第4世代RTコア)を統合し、256-bitバスのLPDDR5X-8533〜9400メモリ(24GB / 32GB / 48GB / 64GB / 128GB)を共有するプラットフォームです。
従来のx86ノートPC+ディスクリートRTX GPU(例:Core Ultra / Ryzen+RTX 5070 / 5080 Laptop)では、GPUが直接扱える専用VRAMは8GB〜16GB(最上位のRTX 5090 Laptopでも24GB)に限られていました。RTX Sparkの最大の転換点は、70W〜85Wクラスの薄型15〜16インチノートPCや小型デスクトップでありながら、CPUとCUDA GPUが最大128GBの単一物理メモリ空間(UMA)を共有できることにあります。
【重要】従来の「Windows 50%上限」とは異なる、RTX Sparkの新しいUMA管理仕様
ここで正確に理解しておくべきなのが、「RTX Sparkで実際にGPUが何GBまで使えるのか?」というメモリ管理の仕組みです。従来の一般的なWindows統合GPU(WDDM標準仕様)では、共有GPUメモリの上限が一律で物理RAMの約50%(128GB機なら64GB)に固定されるケースが多くありました。しかし、NVIDIA公式の『RTX Spark Porting Guide(UMA仕様書)』では、単一の物理DRAMプールを以下の3つの論理領域に分割して管理する新しい仕様が定義されています。
-
GPU専用領域(Dedicated GPU memory / carveout):
システムDRAMの一部をiGPU専用として予約した領域で、Windowsからは「専用GPUメモリ(VRAM)」として報告されます。CUDAのcudaMalloc等のGPU専用割当はまずこのcarveout領域に配置され、大きなページサイズと内部アライメント最適化により最も高いアクセス性能を発揮します。 -
共有システムメモリ領域(Shared system memory):
Windowsが管理し、CPUとiGPUの双方がアクセスできる領域です。ディスクリートGPU機では共有メモリがPCIe経由の「非ローカル」扱いになるのに対し、RTX SparkのiGPUでは共有領域もGPUにとって「ローカル(DXGI_MEMORY_SEGMENT_GROUP_LOCAL)」として扱われます。専用carveoutを使い切るとcudaMallocはこの共有領域へスピル(spill)して割当を継続します(ただし共有領域は小さなページで管理されるため、carveout領域よりアクセス速度が低下する場合があります)。
この共有領域の名目サイズは、専用carveoutを差し引いた残り容量(post-carveout capacity)から16GBを引いた値(post-carveout capacity - 16 GB)を基準としつつ、post-carveout容量の最小50%〜最大80%の範囲にクランプ(制限)されます。 -
CPU専用システムメモリ領域(CPU-only system memory):
post-carveout容量から共有領域を除いた残りの部分(20%〜50%)で、OSおよびCPU専用として保護され、GPU割当には使用できません。
・大容量モデル(64GB / 128GB構成)では、専用carveout+共有領域(post-carveoutの最大80%)を合算することで、従来の「一律50%制限」を超えて物理メモリの大部分をGPUからローカルに利用できます。
・ただし、実際にGPUが使える容量(Budget)は構成・設定・同時に動くアプリのCPUメモリ消費によって動的に変化します(GPU予算を100%使い切るとCPU側のホストメモリが枯渇しOSが応答不能になる恐れがあるため、少し余裕を残す設計が推奨されています)。また、「WSL2へ移行すればWindowsホスト側のUMAメモリ制約を必ず無条件に突破できる」というわけではありません。
・実機での正確な利用可能枠は、固定値で推測するのではなく、CUDA環境では
cudaMemGetInfo(専用+共有の合算バジェットを確認。nvmlDeviceGetMemoryInfo_v2は専用carveoutのみを返す点に注意)およびcudaDeviceRegisterAsyncNotification(メモリ圧迫時のトリム通知)、DirectX 12環境ではIDXGIAdapter3::QueryVideoMemoryInfo(DXGI_MEMORY_SEGMENT_GROUP_LOCALで合算Budgetを取得)およびDXGI_ADAPTER_DESC1(DedicatedVideoMemoryとSharedSystemMemoryの個別確認)で取得するのが公式の標準手順です。
| 6つの評価軸 | NVIDIA RTX Spark N1X(ノート/小型DT) |
GeForce RTX 5090 デスクトップBTO |
AMD Ryzen AI Max + 395 / + PRO 495 |
Apple Mac Studio M5 Max / M5 Ultra |
|---|---|---|---|---|
| ① Capacity メモリ容量・GPU利用枠 |
24GB / 32GB / 48GB / 64GB / 128GB LPDDR5X共有(増設不可)。GPU専用carveout+共有領域(post-carveoutの50〜80%)をローカルGPUメモリとして利用可。 |
32GB 専用GDDR7 +システムRAM 32〜192GB(ただし32GB超過分はPCIe経由の非ローカル転送となり急減速)。 |
64GB / 128GB(PRO 495は最大192GB) AMD VGM機能により、128GB機で最大96GB(192GB機はさらに上)を固定VRAM相当として割当可能。 |
M5 Max:36 / 48 / 64 / 128GB M5 Ultra:96 / 256 / 512GB macOS標準で物理メモリの大部分をGPU(Metal/MLX)からシームレスに利用可能。 |
| ② Bandwidth メモリ帯域幅 |
約273〜301 GB/s 256-bit LPDDR5X-8533 / 9400。Ryzen AI Maxとほぼ同等の帯域クラス。 |
1,792 GB/s 512-bit GDDR7。共有メモリ機の約1.5〜6.5倍に達する圧倒的な専用帯域。 |
約256 GB/s(PRO 495は最大約272 GB/s) 256-bit LPDDR5X-8000 / 8533。容量単価重視の設計。 |
M5 Max:460 GB/s(上位614 GB/s) M5 Ultra:1.2 TB/s(1,200 GB/s) 共有メモリ勢の中で頭一つ抜けた広帯域。大規模LLMの生成速度に直結。 |
| ③ Compute 演算規模・GPUクラス |
6,144 CUDAコア(下位5,120コア) 最大20コアArm CPU。3DMark実測はRTX 5070 Laptop相当。第5世代Tensorコア搭載。 |
21,760 CUDAコア(Blackwell) 民生GPU最高峰。レンダリング・動画生成・学習で他を圧倒。 |
Radeon 8060S(40 CU / RDNA 3.5) 16コアZen 5 CPUは強力。3DMark GPU性能はRTX Sparkが約31〜36%上回る。 |
M5 Max:32 / 40コアGPU(18c CPU) M5 Ultra:64 / 80コアGPU(30/36c CPU) M5 Max(40c)のSteel Nomad実測(4,386)はRTX Spark(2,924)を約50%上回る。 |
| ④ Compatibility OS・API・アプリ互換 |
Windows 11 on Arm + CUDA WSL2 Linux Arm64のCUDA資産は強力。一方、Windowsネイティブのx64制作アプリには互換の壁あり。 |
Windows 11 / Linux(x86_64)+ CUDA AI・3DCG・ゲーム・VJの全領域で業界標準の最高互換。 |
Windows 11 / Linux(x86_64)+ ROCm / Vulkan OS・CPUアプリ互換は盤石。CUDA専用AIツールのみ非対応。 |
macOS(Apple Silicon Arm64)+ Metal / MLX クリエイティブソフトのArmネイティブ最適化は成熟。CUDAは非対応。 |
| ⑤ Operation 消費電力・騒音・携帯性 |
70〜85W(ノート)/ 120W級(小型DT) 最大128GB+CUDAを15〜16型・約1.8〜2.0kgで持ち運べる唯一無二の機動性。 |
GPU単体575W / システム全体700〜900W級 大型ケース、1200W級電源、室温・排熱・ブレーカー対策が必須。 |
55〜120W(ミニPC・ノート) 省スペース・低消費電力で24時間常駐AIノードとして極めて優秀。 |
実測100〜250W前後(据え置き) 高負荷推論中でも極めて静音。デスク上のメイン母艦に最適。 |
| ⑥ Cost 国内税込価格の例(2026年10月確認) |
・Surface Laptop Ultra(24GB最小構成):513,480円〜 ・Surface Laptop Ultra(48GB / 1TB・EP2-80729):759,880円 ・ASUS ProArt P16 H7607BA(128GB / 1TB):1,248,000円 (いずれも2026年10月16日確認・税込。共有メモリ容量と筐体グレードで価格帯が大きく異なる) |
単GPU搭載BTO目安:約134万〜185万円 例:GALLERIA XDC7A-R59-CW(RTX 5090 32GB / 32GB RAM)1,339,980円(2026年10月15日確認) |
・GMKtec EVO-X2(128GB):583,000円 ・MINISFORUM MS-S1 MAX(128GB):659,999円 ・DAIV CX-A9A60(128GB):949,800円〜 ・EVO-X5 Pro(PRO 495 / 192GB):1,055,840円 (2026年9月30日〜10月6日確認) |
・Mac Studio M5 Ultra(96GBベース構成):949,800円〜 (2026年9月30日確認。M5 Max 36GB〜128GB構成からM5 Ultra 256GB/512GB構成までCTOで段階的に設定) |
補足:RTX Spark(N1X)と「DGX Spark(GB10)」は何が違うのか?
SNSやスペック比較で最も起きやすい誤解が、「DGX Spark(GB10 / 128GB)」のLinuxベンチマーク結果を、そのまま「RTX Spark(N1X)」のWindows性能や64GB以下の構成と同一視してしまうことです。両者は最大20コアArm CPU+最大6,144コアBlackwell GPU+256-bit LPDDR5Xという基本シリコン構造こそ共通していますが、OS・メモリ管理・構成容量・ネットワーク拡張性・想定ユーザーが明確に分かれています。
- 対象:Windows 11 on Arm搭載のノートPC・小型デスクトップ(ASUS ProArt P16/P14、Surface Laptop Ultra、Alienware等)
- メモリ容量:24GB / 32GB / 48GB / 64GB / 128GB(機種・SKUにより異なり購入後の増設不可)
- メモリ管理:Windows UMA仕様に基づき、GPU専用carveout+共有領域(post-carveoutの50〜80%)+CPU専用領域に分割管理
- 主な役割:日常のWindows業務・モバイル制作とローカルAI開発を1台で兼ねるクライアントPC
- 対象:NVIDIA純正およびOEM(ASUS Ascent GX10、Dell、HP、Lenovo等)の据え置き小型AIアプライアンス
- メモリ容量:128GB LPDDR5X固定(+ConnectX-7 200GbE NIC内蔵で2台連結256GB構成に対応)
- メモリ管理:Ubuntu LinuxベースのDGX OSにより、LinuxネイティブのCUDA/vLLM/TensorRT-LLMスタックへ128GBユニファイドメモリを直接割当可能
- 主な役割:画面を繋がずSSHやAPI経由で叩く、純粋なローカルAI開発・推論サーバー
※DGX Sparkを含めた4つのユニファイドメモリ方式のアーキテクチャ比較については、「RTX Spark・Ryzen AI Max・DGX Spark・Mac Studioの違い|4つのユニファイドメモリ方式を比較」で詳しく解説しています。
3. 【AI・開発編】ローカルLLM・AIエージェント・ComfyUIはどこまで置き換えられるか?
では、実際のベンチマークではどこまで差が出るのでしょうか。ここでは2026年10月15日に解禁されたRTX Spark(N1X)搭載実機の第三者レビュー計測値(Notebookcheck・Windows Central・HotHardware)をベースに、①64GB実測機(Notebookcheck検証機)、②128GB製品仕様(最上位SKU)、③DGX Spark(GB10 / Linux / 128GB)の参考実測値を厳密に区別しながら、AIワークフロー(用途A・B・C)の代替可能性を検証します。
2026年10月15日公開:RTX Spark(N1X)実機ベンチマーク検証
まずは、公称の「FP4最大1,000 TOPS級」というマーケティング数値ではなく、実際に公開されたASUS ProArt P16 H7607(NVIDIA RTX Spark N1x 675:20コアCPU・6,144コアGPU / 64GB LPDDR5X-9400 / Windows 11 on Arm / 最大85W・持続70W)およびMicrosoft Surface Laptop Ultra(RTX Spark N1X / 64GB実測機 / Windows 11 on Arm)の測定データを見てみましょう。
| ベンチマーク項目・測定条件 | RTX Spark (N1X) ProArt P16 H7607 (64GB / Win11 Arm) |
Ryzen AI Max+ 395 Flow Z13 / PX13 (Win11 x64) |
Apple M5 Pro / M5 Max MacBook Pro 16 2026 (macOS) |
RTX 5090 Laptop (24GB) ※Desktop 32GBは別枠注記 |
|---|---|---|---|---|
| CPU:Cinebench 2024 Single / Multi(Notebookcheck) |
130 pts / 1,726 pts Single時30.5W、Multi時システム全体127.1W(13.6 pts/W)。 |
116.8 pts / 1,648〜1,673 pts Multiはほぼ同等(14.7〜15.1 pts/W)、SingleはN1Xが約11%リード。 |
M5 Pro (18c): 201 / 2,347 pts M5 Max (18c): 199 / 2,490 pts CPU性能・ワット効率(21.2〜23.0 pts/W)はM5世代が首位。 |
(同チャートCPU項目はSoC比較のみ。x86 HX搭載機はCPU型番に依存) |
| CPU:Geekbench 6.7 Single / Multi(Notebookcheck) |
3,092 / 20,296 (N1x 675 / 20コア / 64GB機) |
2,975〜2,978 / 19,364〜21,269 (ProArt PX13 / ROG Flow Z13) |
M5 Pro (18c): 4,295 / 28,436 M5 Max (18c): 4,336 / 30,057 |
(同チャート未掲載) |
| GPU:3DMark Steel Nomad 標準 / Light(Notebookcheck) |
2,924 / 12,992 RTX 5070 Laptop(2,906〜3,075)と完全に同クラス。 |
1,874〜2,019 / 9,653〜9,866 RTX SparkがRadeon 8060Sを+31〜36%上回る。 |
M5 Pro (20c GPU): 2,323 / 10,018 M5 Max (40c GPU): 4,386 / 17,649 |
RTX 5090 Laptop (24GB): 4,959 / 21,012 ※ProArt P16 RTX 5090 / Legion 9実測。Desktop版RTX 5090はさらに約2.8倍規模。 |
| LLM:Llama 3.1 8B MLPerf Client 2.0 GPU(Notebookcheck) |
Decode: 55.8 tokens/s TTFT: 0.30秒 / SWE完了: 46.2秒 ※Surface Laptop Ultra(Windows Central・Procyon AI)では49.44 t/s(TTFT 0.39秒)。 |
(同条件MLPerf Client 2.0未測定) | M4 Pro (16c): 37.4〜43.2 t/s(TTFT 2.25〜2.37秒) M5 Pro (20c): SWE完了 55.4〜74.5秒 (同条件でM5 Max / M5 Ultraは未測定) |
RTX 5090 Laptop (Legion 9): 123.7 t/s TTFT: 0.15秒 / SWE完了: 24.7秒 |
| LLM:Qwen 3 8B & SWE Agent MLPerf Client 2.0 GPU(Notebookcheck) |
Decode: 53.8 tokens/s TTFT: 0.27秒 / SWE完了: 46.1秒 |
(同条件MLPerf Client 2.0未測定) | M5 Pro (20c): 52.3 t/s(TTFT 0.54秒) SWE完了: 55.7秒 (M4 Pro 16cは47.5 t/s・TTFT 2.32秒) |
RTX 5090 Laptop (Legion 9): 119.0 t/s TTFT: 0.15秒 / SWE完了: 25.7秒 |
| 画像生成:Stable Diffusion 1.5 Procyon AI INT8(Windows Central) |
11,294 pts(2.77秒/枚) (Surface Laptop Ultra実測。TensorRT INT8が効く軽量モデルで高速) |
(同条件未測定) | (同条件未測定) | (同条件未測定。※大型FP16/BF16モデルでは専用GDDR7機が圧倒) |
・また、ネット上で出回っている「Llama 3.3 70B(Q4)で約7.8 tokens/s」「GPT-OSS-120B(MoE / FP4)で約38〜58 tokens/s」といった超大規模LLMの数値の多くは、先行して流通したLinux(DGX OS)搭載の据え置き機「DGX Spark(GB10 / 128GB)」上で計測された参考実測値です。Windows 11 on Arm上のRTX Sparkでは、UMAの3領域分割(GPU専用carveout+post-carveoutの50〜80%共有領域+CPU専用領域)と動的メモリ予算の範囲内でGPUメモリが割り当てられるため、構成容量やOS常駐状況によって実際に載せられるモデルサイズが変化します。
用途A:ローカルLLM推論(8B/32B/70B/120B)の代替判定
- 8B〜32Bクラス(日常のコーディング補助・要約・チャット):◎ 十分に代替可能
MLPerf Client 2.0(64GB実測機)が示す通り、RTX SparkはBlackwellの第5世代TensorコアによってPrompt処理(TTFT:最初の1文字が出るまでの時間)が0.27〜0.30秒と非常に速く、生成速度も8Bで約49〜56 tokens/sに達します。16GB VRAMの一般的なノートPCでは苦しい32Bモデル(Q4〜Q8)+長文KVキャッシュも、64GB〜128GB構成のRTX SparkならUMAの専用+共有バジェット内に余裕をもって保持できます。 - 70B〜120Bクラス(大規模Denseモデル・MoEモデル):△ 「128GB構成なら収容圏内」だが「速度は帯域なり」
RTX 5090 Desktop(32GB VRAM)では単体VRAMに収まらない70B〜120Bモデルも、128GB構成のRTX SparkであればUMA(専用carveout+共有領域)を通じてローカルメモリ内に収容できる設計上の強みがあります。ただし、LLMのトークン生成速度は「メモリ帯域÷アクティブなモデル容量」に強く依存するため、帯域約273〜301GB/sの256-bit LPDDR5X環境では、70B Denseモデル(約40GB)で秒間7〜8トークン前後(同帯域のDGX Spark参考値)が物理的な天井になります。70B以上を毎日ストレスのない速度で回したいなら、M5 Max(460GB/s・上位614GB/s)やM5 Ultra(1.2TB/s)を搭載するMac Studioの方が明確に快適です。
用途B:AIエージェント・コーディングAI・RAGの代替判定(クラウド型とローカル型の切り分け)
判定:◎ ローカル推論・RAG併用開発で有力な代替候補(ただし「クラウドAPI推論」との混同に注意)
Claude Code、Codex、CursorなどのAIエージェントやコーディングAIを目的としてPCを選ぶ際は、「どの処理がクラウドで動き、どの処理がローカルPCで動くのか」を切り分けて考える必要があります。
Claude CodeやCodex、Cursor等でAnthropicやOpenAI等のクラウドAPI上のモデルを呼び出して推論させる場合、AIの思考・生成速度はクラウド側サーバーと通信回線に依存するため、RTX SparkのGPUを買ってもAPIの応答自体は速くなりません。
この使い方で効くのはGPUではなくCPUとシステムRAM容量(64GB〜128GB)です。複数のIDE、数十枚のブラウザタブ、Dockerコンテナ、ローカルビルド、大規模リポジトリのインデックス保持を同時に動かしてもメモリ不足でスワップしない快適な開発母艦として機能します。
社外秘コードのローカル補完、ローカルLLMによるサブエージェント実行、ローカルEmbeddingモデル+ベクトルDB(Qdrant / Milvus / Chroma)によるローカルRAGを自機上で直接動かす場合は、RTX SparkのBlackwell GPU(CUDA)・UMA容量・メモリ帯域がそのまま性能を決定します。
NotebookcheckのMLPerf SWE Agent(ローカル8Bモデルを用いたソフトウェア開発エージェント処理)でも、RTX Spark(46.1〜46.2秒)はApple M5 Pro(55.4〜74.5秒)を上回る処理速度を記録しており、バッテリー駆動や70W前後の省電力でローカルAI開発環境を持ち運べる価値は非常に大きいです。
用途C:ComfyUI・画像生成・動画生成AIの代替判定
判定:△ ワークフロー構築・OOM回避には有効だが、量産・動画生成でRTX 5090の代わりにはならない
ComfyUIやPyTorchを使う場合、まず知っておくべき技術的注意点があります。Windowsネイティブ(win_arm64)環境では、PyTorchのCUDAビルドやカスタムノード(xformers、triton、sageattention、insightface等のC++/CUDAコンパイル済み拡張)のプリビルドWheelが揃っていないケースがあります。
そのため、RTX SparkでComfyUIや本格的なCUDAパイプラインを動かす際は、WSL2(Ubuntu aarch64)上でLinux Arm64版CUDA+PyTorchパッケージを動かす運用が実質的な標準ルートになります(NVIDIAはGrace Hopper / Grace Blackwell向けにLinux aarch64 のCUDAエコシステムを重点整備しているため、パッケージ互換性を確保しやすくなります。※ただし前述の通り、WSL2を使えばWindowsホスト側のUMAメモリ予算制約が無条件に消えるわけではない点には注意してください)。
そのうえで性能面を見ると、Flux.1 + 複数ControlNet + LLMテキストエンコーダ同時載せのように「16GB〜24GB VRAMの従来ノートではOut of Memory(OOM)で落ちる構成」を大容量UMAで通せる価値はあります。しかし、Wan 2.1 / HunyuanVideo等の動画生成AIや大量バッチ画像生成では、メモリ帯域1,792GB/s・21,760コアを持つデスクトップRTX 5090と数倍の生成時間差がつくため、制作本番機の代替にはなりません。
4. 【制作・ゲーム編】3DCG・映像・VJ・リアルタイム制作の互換性と実用性
クリエイターがRTX Sparkを検討する際、最も危険な思い込みが「NVIDIAのRTX GPUでCUDAに対応しているのだから、普段Windowsで使っている3DCGソフトや映像ソフト、VJソフトもすべてそのまま動くはずだ」という判断です。
Windows 11 on ArmにはMicrosoftの「Prism」エミュレータが搭載されており、多くのx86_64アプリを変換実行できます。しかし、①アプリ本体がArm64ネイティブか、②x86_64エミュレーション下で独自メモリアロケータやインストーラが通るか、③エミュレーション越しにGPUレンダラ(CUDA / OptiX / Vulkan / OpenGL)や外部プラグイン・ハードウェアが正常に動くかは、まったく別の問題です。
| ソフトウェア/用途 | ① 公式ネイティブ (Windows Arm64) |
② エミュレーション動作 (Prism x86_64変換) |
③ GPU・CUDA機能/ プラグイン動作確認 |
④ 実務での代替判定 (2026年10月時点) |
|---|---|---|---|---|
| Blender (3DCG・Cycles) |
○ 公式Arm64版あり | x64版もエミュレーション起動可(アドオン互換用) | ビューポート描画は動作。Cycles CUDA/OptiXのArm64有効化はビルド・ドライバ版により個別確認要。 | △ モバイル確認・中規模制作向け GPU基礎速度はRTX 5070 Laptop級のため、重い本番レンダリングはRTX 5090が圧倒。 |
| Unreal Engine 5 (ゲーム・背景・VP) |
△ ソースビルド等に限られる | x64版エディタはエミュレーション動作対象 | DX12描画は動作するが、外部x64プラグイン・VR・Live Link等の実務安定性は動作未確認が多い。 | △ 検証・ビューア用途まで メイン開発機としてはx86_64+ディスクリートRTXを推奨。 |
| SideFX Houdini (VFX・プロシージャル) |
✕ Windows Arm版なし ※Linux Arm版のみDGX Spark向けTech Previewあり |
△ エミュレーション動作見込み (SideFX公式フォーラム回答) |
? 動作未確認 Karma XPU(OptiX)やRedshift等のエミュレーション下GPU動作は未保証。 |
✕ 本番VFX機の代替は不可 Linux Arm検証ならDGX Spark、Windows実務ならx86_64 RTX機を選ぶべき領域。 |
| TouchDesigner (リアルタイム映像・展示) |
✕ 公式ネイティブ非対応 ※開発元が社内Arm実機で将来対応を調査・検討中 |
✕ 標準インストーラ不可 展開時も mimalloc.dllのエミュレーション不具合を調査中 |
? 動作未確認 CUDA TOP / Optical Flow / 各種センサーSDKは未検証。 |
✕ 現時点で代替不可 展示・ライブ現場はx86_64 RTXノート/DTまたはApple Silicon Macが必須。 |
| Notch / Resolume (ライブ演出・VJ) |
✕ Windows Arm版なし (ResolumeはmacOS Armのみネイティブ) |
x64エミュレーション頼み(ドングル・Spout周辺にリスク) | ? 動作未確認 | ✕ 現場投入は非推奨 安定性が最優先される本番オペレーションには不向き。 |
| Adobe Premiere Pro / After Effects |
○ Arm64版あり ※公式要件文書はSnapdragon記述が中心 |
x64プラグインは原則非互換または制限あり | 実機レビューでPremiere / Photoshopの動作を確認。個別GPUエフェクト・外部プラグインは要検証。 | ○ 標準編集は代替可 外部プラグイン多用のAfter Effects案件はx86_64またはMacが安全。 |
| DaVinci Resolve (編集・カラー・Fusion) |
◎ 公式Windows Arm64対応 | ネイティブ動作のため不要 | ○ 64GB実機で動作確認済み 標準PugetBenchでは控えめだが、8〜12GB VRAM機が詰まる大量RAW素材では大容量UMAが有利。 |
○ モバイル編集機として有力 純粋なGPU処理・書き出し速度ではRTX 5090やMac Studio M5世代が上位。 |
| PCゲーム (Steam / 最新3Dゲーム) |
△ 一部タイトルのみArm対応 (Marvel Rivals等) |
大半のゲームはx64エミュレーション動作(約20%のFPS低下と1% Low低下) | DLSS・レイトレは機能するが、カーネルレベルAnti-Cheat採用作(F1 25 / BF6等)で起動不可例あり。 | △ ゲーム主目的には不向き ゲームも重視するならx86_64のRTX搭載機を選ぶべき。 |
TouchDesignerとHoudiniに関する開発元の公式見解(2026年10月時点)
メディアアート・インスタレーション・VFX領域で特に質問が多いTouchDesignerとHoudiniについては、各開発元の公式フォーラムで以下の通り一次回答が示されています。
【TouchDesigner(Derivative公式フォーラム・2026年10月7日 開発者回答の要点)】
DerivativeはWindows on Arm対応を否定しておらず、社内にもArm実機を導入して将来のインストーラ改善・Armビルド対応に向けた調査を進めています。ただし2026年10月時点では公式ネイティブ非対応であり、現行インストーラを展開してPrismエミュレーションで動かそうとした場合も、メモリ管理ライブラリ(mimalloc.dll)がエミュレーションモードで正常に動作しない問題が確認されており、修正方法が検討されています。
【Houdini(SideFX公式フォーラム・2026年10月1日 スタッフ回答の要点)】
Houdini 22ではLinux版の「DGX Spark」向けにネイティブ動作するLinux Armビルド(Technical Preview)が提供されています。一方、Windows版の「RTX Spark」向けには現時点でネイティブArmビルドは存在せず、Windowsのx86_64エミュレーション上で動作する見込み(should run in emulation)と案内されています。そのため、Karma XPUやサードパーティ製GPUレンダラを含む全機能の実務安定性は現時点で動作未確認です。
つまり、「NVIDIA GPUが載っているからTouchDesignerやHoudiniも既存のWindowsワークステーションと同じように動く」と考えてRTX Sparkをメイン制作機として購入するのは明確に危険です。リアルタイム制作やVFXの本番環境については、「RTX 5090・Mac Studio・Ryzen AI Maxを仕事別比較」や「リアルタイム制作環境(Mac / Ryzen / RTX 5090)の選び方」で整理している通り、実績のあるx86_64 RTX環境またはApple Siliconネイティブ環境を軸に据えるべきです。
映像制作(Adobe・DaVinci Resolve)とゲーム性能の実測評価
映像編集分野では、確認できる実測結果とメモリ容量による構造的な優位性を分けて見る必要があります。DaVinci ResolveはWindows on Armネイティブ版が提供されており、Notebookcheckの64GB実測機(ASUS ProArt P16 H7607)によるPugetBench検証では、標準ベンチマーク自体が多くのVRAMを必要とせず、純粋なGPU演算速度やmacOS向けの最適化が効きやすいため、ベンチマークスコア自体はやや控えめな結果となっています。その一方で同レビューが指摘している通り、多数の高解像度RAWフッテージを扱い8GB〜12GB VRAMクラスの一般的なノートGPU(RTX 5070 Laptop等)ではVRAMがすぐに溢れてしまうような実務場面においては、64GB〜128GBの大容量共有メモリを持つRTX Sparkが容量面で優位に立つ設計になっています。
Adobe Premiere Pro / After Effects / PhotoshopについてもArm64版が存在し、64GB実測機のPugetBench Photoshop検証ではRyzen AI Max+ 395(Strix Halo)と同等クラスの良好なスコアが確認されています(CPU性能が効く場面ではApple M5 Proが先行)。ただし、Adobe公式のWindows on Armシステム要件ページには依然としてQualcomm Snapdragon Xシリーズを前提とした記述が残っており、x86_64専用のサードパーティ製プラグイン(After Effectsの外部エフェクト等)は動作しない点に注意が必要です。
また、PCゲーム・リアルタイム描画については、GPUの基本ラスタライズ性能がGeForce RTX 5070 Laptop相当(『サイバーパンク2077』1080p Ultra設定で平均63.1 fps、1440p Ultra設定で平均46.4 fps ── いずれも64GB実測機・x64エミュレーション動作)と健闘しているものの、Notebookcheckの『Marvel Rivals』検証ではx64エミュレーション動作時はネイティブArmビルドに比べて平均フレームレートが約20%低下し、1% Lowフレームレートも大きく落ち込む(9 fps vs 29 fps)ことが判明しています。アンチチート非対応タイトルもあるため、ゲーム目的での代替には向きません。
5. 「1台集約」か「2台分業」か? 失敗しない6つの購入判断と実機確認ガイド
ここまでの検証を踏まえると、2026年後半のハイエンドPC選びは「どれが一番スペックが高いか」ではなく、「自分の作業ボトルネックに対して、どの環境を1台選ぶか(あるいは2台に分業するか)」という意思決定になります。6つのタイプ別に最適解を整理します。
モバイル1台で「大容量メモリ+CUDA / WSL2開発」を完結したい人
- 外出先や複数拠点で、8B〜32B(128GB構成なら条件付きで70B級)のローカルLLM・ローカルRAG・AIエージェント開発を行いたい
- WSL2(Ubuntu Arm64)上でNVIDIAのCUDA / TensorRT-LLM / PyTorch資産をそのまま動かしたい
- 16GB〜24GB VRAMの従来型RTXノートではメモリ容量が足りず、MacBook ProではCUDAが使えないことに悩んでいた
動画生成AI・3DCG本番レンダリング・TouchDesigner/UE5が主戦場の人
- ComfyUIでの動画生成(Wan / Hunyuan等)や大量生成の待ち時間(演算速度)を最短にしたい
- Blender Cycles(OptiX)、Unreal Engine 5、Houdini、TouchDesigner、Notchをx86_64の完全互換で動かしたい
- 32GB以内に収まる処理を、1,792GB/sの最高帯域で回すことが収益や制作密度に直結する(BTO目安:約134万〜185万円)
x86_64互換と高コスパな128GB〜192GB常駐AIノードを求める人
- 既存のx86_64 Windows / Linuxアプリ互換を一切犠牲にせず、最大96GB超のGPU割当(VGM)を使いたい
- 約58.3万〜66万円前後の128GBミニPC(EVO-X2:583,000円 / EVO-X3:649,100円 / MS-S1 MAX:659,999円等)で、70B級LLMやRAGサーバーを24時間常駐させたい
- ノートPCのOLEDディスプレイやバッテリーに予算を払わず、純粋な大容量メモリ単価を重視したい
70B〜120B超の推論速度と、静音・高完成度な机上制作母艦を求める人
- M5 Max(460GB/s・上位614GB/s)やM5 Ultra(1.2TB/s)の圧倒的なユニファイドメモリ帯域で、70B〜120B超のLLMを実用的なトークン速度で回したい
- 128GBを超えて256GB・最大512GB(M5 Ultra)までの超大容量構成が必要
- 映像編集(Premiere / DaVinci / Final Cut)やApple Siliconネイティブ対応済みのTouchDesigner / 音楽制作を無音に近い環境で行いたい
「x86 RTXの制作互換・速度」と「128GBの大容量AI常駐」を両立したい人
- すでにRTX 4070 Ti / 4080 / 4090 / 5080 / 5090搭載のメイン制作PCを持っている
- メイン機のVRAMを3DCGやComfyUI、映像編集に100%残したまま、ローカルLLMやCoding Agentを別マシンへ逃がしたい
- 1台にすべてを詰め込んでArm互換リスクを抱えるより、「制作はx86 RTX、思考・常駐AIは128GBノード(Ryzen AI Max / DGX Spark / RTX Spark)」と役割分担する方が合理的
稼働時間が短く、最新フロンティアモデルの精度だけを必要とする人
- 機密データのローカル保持要件がなく、Claude / GPT / Gemini等のクラウドAPIで業務が完結する
- 重いGPU処理は月に数回だけで、RunPodやLambda等の時間貸しクラウドGPUを使った方が損益分岐点として安い
特に注目したいのが「DECISION 05:既存のRTX制作PCを活かした2台分業」です。RTX Sparkの登場によって「1台で何でもできる夢のPC」を探したくなりますが、実務でTouchDesignerやUnreal Engine、Houdini、高速なComfyUI動画生成を回しているクリエイターほど、メイン機はx86_64のRTXデスクトップに残し、大容量LLMやAIエージェントを2台目の128GBノードへ分離する構成が最も安定します。この設計については「RTX制作PC+128GB AIミニPCの2台構成は有効?」および「RTX+大容量AIノードの2台構成で、何ができて何ができないのか」で詳しく解説しています。
RTX Spark(N1X)搭載PCの展開状況と、購入前に必ず確認すべき3つの仕様
2026年10月16日時点で国内発表・予約受付が行われている代表的なRTX Spark(N1X)搭載機には、ASUS ProArt P16(H7607:128GB RAM / 1TB SSD構成で税込1,248,000円、2026年10月23日発売予定)・ProArt P14(H7407BA)や、Microsoft Surface Laptop Ultra(15型:48GB RAM / 1TB SSD構成『EP2-80729』で税込759,880円、24GB最小構成は税込513,480円〜)のほか、Alienware(Dell)、HP、Lenovo、MSIなどのモデルがあります。購入や予約を検討する際は、以下の3点を必ず各製品ページで確認してください。
- メモリ容量(24GB / 32GB / 48GB / 64GB / 128GB)はオンボード固定で後から増設できず、価格差も大きい:
RTX SparkのLPDDR5Xメモリは購入後の増設が不可能です。また、24GB最小構成(51万円台〜)、48GB中位構成(75万円台)、128GB最上位構成(124.8万円クラス)では価格帯もGPUが利用できるUMA予算(dedicated carveout+post-carveoutの50〜80%)も大きく異なります。「RTX 5090の32GB VRAMを超える大容量モデルを載せる」ことが目的なら、48GB〜64GB以上(本格的な70B級や複数ワークロード常駐なら128GB構成)が前提になります。 - SoCのコア数グレード(20コアCPU・6,144コアGPU vs 18コアCPU・5,120コアGPU)と持続TDP:
同じRTX Spark(N1X)搭載機でも、下位構成では18コアCPU / 5,120コアGPUとなるSKUが存在します。また筐体によって持続パッケージ電力(70W〜85Wノート vs 120W級小型デスクトップ)が異なります。 - 実機到着後のUMAメモリ予算の確認方法:
購入した構成で実際にCUDAやDirectXアプリが確保できるメモリ予算は、cudaMemGetInfoまたはIDXGIAdapter3::QueryVideoMemoryInfo(DXGI_MEMORY_SEGMENT_GROUP_LOCAL)で確認し、ホストCPUメモリを枯渇させない範囲で運用してください。
RTX Spark搭載PCの購入候補2選|128GBと48GB、どちらを選ぶ?
ここまでの実務代替判定を踏まえ、「自分のワークフローにはRTX Spark(N1X)のモバイルCUDA+共有メモリ環境が合っている」と判断した場合、実際の製品選びは「128GB構成で大容量ローカルAI・複数ワークロードの集約を狙うか」、それとも「48GB構成で導入コストを抑えつつCUDA対応のモバイルAI開発機を持ち歩くか」という2つの選択肢に分かれます。
※以下の製品紹介にはアフィリエイト広告(PR)が含まれます。掲載価格・予約状況・仕様は2026年10月16日時点の各販売ページ確認情報であり、時期や選択構成により変動する場合があります。
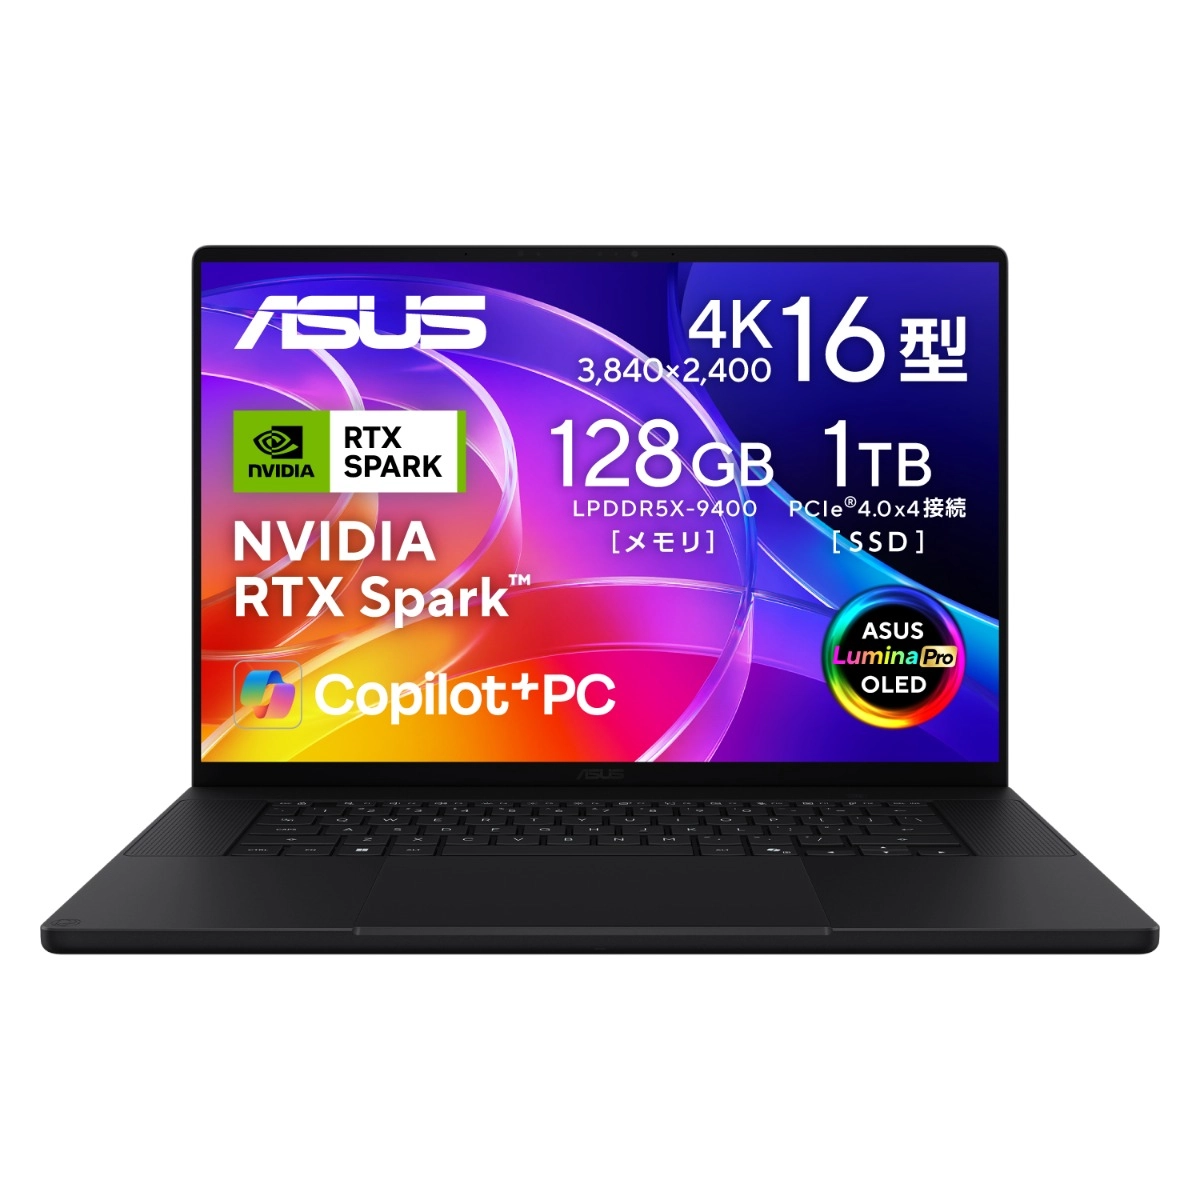
ASUS ProArt P16 (H7607)
CUDA対応の大容量AI環境をモバイルPCに集約したい人へ。
128GBの共有メモリを搭載し、32GBの専用VRAMでは収まりにくい大規模モデルや複数のAIワークロードを扱いたい人向けの構成です。ただし、128GBすべてをGPU専用VRAMとして利用できるわけではなく、実効メモリ容量や対応アプリ、推論速度によって利用可能なワークロードは変化します。
※指定型番 H7607BA-NX1281BLP はナノブラックモデルです。リンク先のASUS公式ストア構成選択ページ(H7607BA / モデル番号 31150-JP-CNF)では、初期表示として同仕様・同価格(128GB / 1TB / 税込1,248,000円 / 2026年10月23日発売予定)のネオホワイトモデル H7607BA-NX1281WHP が表示される場合があります。購入時は販売ページ上の表示型番・本体カラーをご確認ください。
Surface Laptop Ultra
RTX SparkのCUDA環境を持ち歩きたい人へ。
48GBの共有メモリを搭載した構成です。コーディング、比較的小規模なローカルLLM、AI開発環境の持ち運びを重視する人に適しています。128GB構成より導入価格を抑えられますが、大規模LLMの常駐や複数モデルの同時実行では容量が制約になる可能性があります。
※15.0型 / ナイトフォール(メーカー型番 EP2-80729)。別構成として24GB RAM最小構成(税込513,480円〜)等も展開されているため、購入時はメモリ容量(48GB)とストレージ容量(1TB)をご確認ください。
| 比較項目 | ProArt P16 | Surface Laptop Ultra |
|---|---|---|
| 共有メモリ | 128GB | 48GB |
| SSD | 1TB | 1TB |
| CPU | N1X / 20コア | N1X / 20コア |
| GPU | Blackwell / 6,144コア | Blackwell / 6,144コア |
| 掲載価格 | 1,248,000円 | 759,880円 |
| 重視する用途 | 大容量LLM・AI開発 | モバイルAI開発 |
| 購入前の注意点 | 高価格・互換性 | 大規模モデルの容量制約 |
RTX Sparkの最大の特徴である「大容量共有メモリ+CUDA」を活かすなら、128GB構成のProArt P16が本来の比較対象になります。
一方で、128GBまでの容量を必要とせず、CUDA対応のモバイルAI開発機として導入したい場合は、48GB構成のSurface Laptop Ultraが現実的な選択肢になります。
※RTX Spark(N1X)の共有メモリ管理(UMAの3領域分割・動的メモリ予算)やCUDA / DirectX 12におけるメモリ取得APIの詳細は、以下のNVIDIA一次資料で確認できます。
6. まとめ:スペックの数字ではなく「どこで処理が止まるか」で選ぶ
RTX Sparkは、これまでトレードオフの関係にあった「最大128GBのユニファイドメモリ」と「NVIDIA CUDAエコシステム」を、省電力なモバイル/小型PCフォームファクタで結びつけた画期的なプラットフォームです。
しかし、既存の計算環境をすべて置き換える「万能な1台」ではありません。判断に迷ったときは、自分の作業が次のどこで止まっているのかを確認してください。
- 「モバイル環境でCUDAを使いながら、24GB〜32GBを超えるローカルAIモデルや開発コンテナを動かしたい」なら、RTX Spark(48GB / 64GB / 128GB構成)が新しい最適解になります。
- 「32GB以内に収まる動画生成AI・3DCGレンダリング・リアルタイム制作を最速かつ完全なx86互換で回したい」なら、迷わずGeForce RTX 5090搭載デスクトップを選ぶべきです。
- 「x86_64互換を維持したまま、コストを抑えて128GB〜192GBの常駐AIノードを増設したい」ならRyzen AI Max、「M5 Max(460/614GB/s)やM5 Ultra(1.2TB/s)の広帯域で70B〜120B超のLLMを静音環境で高速に回したい」ならMac Studioが適しています。
スペック表の「最大128GB」という数字だけで選ぶのではなく、Capacity(容量とUMA配分)・Bandwidth(帯域)・Compute(演算)・Compatibility(Arm/x86互換性)の4つを自分の実務ワークフローに照らし合わせること。それが、2026年のローカルAI・制作PC選びで後悔しないための最も確実な基準です。
よくある質問
RTX Sparkの128GBメモリは、Windows上で128GBすべてをVRAMとして使えますか? +
いいえ、物理メモリ128GBのすべてをGPUだけで占有できるわけではありません。NVIDIA公式のRTX Spark向けUMA(Unified Memory Architecture)仕様では、物理メモリは「①GPU専用領域(carveout)」「②CPUとiGPUの共有システムメモリ領域」「③CPU専用領域」の3つに分割されます。従来のWindows標準(WDDM)における一律50%制限とは異なり、RTX Sparkでは専用carveoutを除いた残り容量(post-carveout)から16GBを引いた値を基準に、post-carveout容量の最小50%〜最大80%が共有領域としてGPUに公開されます。実際にGPUが利用できる容量は構成・設定・他アプリのメモリ消費によって動的に変化するため、CUDAではcudaMemGetInfo(専用carveoutのみはnvmlDeviceGetMemoryInfo_v2)、DirectX 12ではIDXGIAdapter3::QueryVideoMemoryInfo(DXGI_MEMORY_SEGMENT_GROUP_LOCAL)で現在のメモリ予算(Budget)を確認するのが確実です。
RTX SparkはCUDA対応なので、TouchDesignerやHoudiniなどのWindows向け制作ソフトもそのまま動きますか? +
「CUDA対応=すべてのWindows制作ソフトがそのまま動く」わけではありません。RTX SparkのOSはWindows 11 on Armであり、TouchDesignerは2026年10月時点で公式ネイティブArm非対応(開発元が社内Arm実機でインストーラやmimalloc.dllのエミュレーション問題を調査中)です。HoudiniもWindows Armネイティブ版はなくエミュレーション動作見込みとされており、Karma XPUやRedshift等のGPUレンダラがエミュレーション下で安定稼働するかは未確認です。
RTX SparkとDGX Sparkは同じ性能・同じ使い勝手ですか? +
最大20コアArm CPU+Blackwell GPU(最大6,144 CUDAコア)+256-bit LPDDR5X共有メモリという基本シリコン構造は共通していますが、OS・メモリ構成・用途が異なります。DGX Spark(GB10)はUbuntuベースのDGX OSと128GBメモリを採用した据え置きAI開発機で、Linux前提の大規模LLM推論(120Bモデル等)やConnectX-7による2台連結に対応します。一方、RTX Spark(N1X)はWindows 11 on Armを採用したノートPC・小型デスクトップ向けプラットフォーム(24GB〜128GB構成)であり、DGX SparkのLinux 128GB計測値をそのままWindows上のRTX Spark全構成の実測値とみなすことはできません。
ローカルLLM用途なら、RTX SparkとRyzen AI Max、Mac Studioのどれを選ぶべきですか? +
8B〜32Bクラスまでの応答速度やCUDA/TensorRT-LLM・WSL2を活用したローカルAI開発をモバイル1台で完結したいならRTX Spark(64GB/128GB構成)が有力です。一方、x86_64 Windows/Linux互換を保ちつつコストを抑えて128GB〜192GBの共有メモリを確保したいならRyzen AI Max、70B〜120B超のモデルをM5 Max(460GB/s・上位614GB/s)やM5 Ultra(1.2TB/s、最大512GB)の広帯域ユニファイドメモリと静音な机上環境で高速に回したいならMac Studioが適しています。
すでにRTX 4080 / 5080 / 5090搭載の制作PCを持っている場合、RTX Sparkへ買い替えるべきですか? +
メインのx86_64 RTX制作PCをRTX Spark 1台へ置き換えるのは推奨しません。3DCGレンダリング、動画生成、リアルタイム映像制作ではデスクトップRTXの専用GDDR7帯域とx86_64互換性が圧倒的に有利だからです。既存制作PCを残したまま、モバイル開発機または2台目の大容量AIノードとして追加・分業する形が最も失敗しない選択です。
※仕様、価格、ソフトウェア対応状況、ベンチマーク数値は執筆時点(2026年10月16日)の公開情報に基づくものであり、今後のドライバやOS、アプリのアップデートにより変更される場合があります。
- NVIDIA: RTX Spark 公式仕様ページ
- NVIDIA: RTX Spark Porting Guide — Unified Memory Architecture (UMA) 仕様
- NVIDIA: RTX Spark Porting Guide — UMA Memory Reporting and Budgeting (CUDA / DirectX 12)
- NVIDIA: DGX Spark 公式仕様ページ
- ASUS Store 日本公式: ASUS ProArt P16 (H7607BA / RTX Spark 128GB構成) 製品・価格ページ
- ASUS 日本公式: ProArt P16 (H7607) 製品概要
- Microsoft 日本公式: Surface Laptop Ultra 製品・技術仕様ページ
- Notebookcheck: Nvidia RTX Spark Analysis(ASUS ProArt P16 H7607 / N1x 675 / 64GB LPDDR5X-9400 実機ベンチマーク・2026年10月15日)
- Windows Central: NVIDIA RTX Spark Review & Benchmarks(Surface Laptop Ultra 実機検証・2026年10月15日)
- HotHardware: NVIDIA RTX Spark Platform Review(2026年10月15日)
- Derivative Official Forum: Future support for Windows ARM and Nvidia RTX Spark?(2026年10月7日 開発者回答)
- SideFX Official Forum: Houdini on DGX Spark / RTX Spark(2026年10月1日 公式スタッフ回答)
- Adobe HelpX: Premiere Pro 必要システム構成(Windows on Arm 記述)
- NVIDIA: GeForce RTX 5090 公式仕様
- AMD: Ryzen AI Max+ 395 プロセッサ公式仕様
- Apple: Mac Studio(M5 Max / M5 Ultra)技術仕様
🧭 大容量AIメモリ選びの道標
容量、GPU演算、プラットフォーム、実機、配置。
今の迷いに合わせて、必要な判断へ移動できます。
VRAM・RAMとの違いと、大容量共有メモリがローカルAIで注目される理由を理解する。
モデルサイズ、コンテキスト、RAG・Agent運用から必要なメモリ容量を判断する。
モデルを収める容量と、高速に計算するGPU性能の違いから判断する。
RTX Spark・Ryzen AI Max・DGX Spark・Mac Studio。CUDA・OS・メモリ特性から選ぶ。
最大128GBの共有メモリとCUDAを備えるRTX Spark。実測性能・制作アプリ互換性・価格から、既存の計算環境をどこまで置き換えられるか判断する。
完成したAIノードか、OCuLinkで外へ拡張できるAIノードかを判断する。
1台へ集中するか、CUDA制作と大容量AIを別ノードへ役割分担するかを設計する。